थोडक्यात उत्तर: Google एखाद्या पेजचे इंडेक्सिंग तपासण्यासाठी, त्याचा ॲड्रेस प्रोमोपायलटच्या 'पेज इंडेक्सिंग चेकर'मध्ये पेस्ट करा. हे टूल Google एक खरी 'साइट रिक्वेस्ट' पाठवेल आणि URL इंडेक्स झाली आहे की नाही हे सांगेल. जर झाली नसेल, तर ते मेटा रोबोट्स आणि एक्स-रोबोट्स टॅग्ज, परवानगी नसलेले robots.txt, दुसऱ्या URL वर कॅनॉनिकलायझेशन, किंवा गहाळ sitemap.xml यांसारख्या कोणत्याही समस्या तपासेल. त्यानंतर ते समस्यांची कारणे आणि संभाव्य उपायांसह एक निकाल देईल. हे विनामूल्य आहे आणि यासाठी कोणत्याही नोंदणीची आवश्यकता नाही. निकाल कसा वाचावा आणि प्रत्येक समस्येवर काय करावे, हे खाली दिले आहे.
"हे पान एका महिन्यापूर्वी प्रकाशित झाले होते, पण ते Google नाही" हा मला सर्वात जास्त विचारला जाणारा प्रश्न आहे. बऱ्याचदा, डेव्हलपमेंटच्या वेळी विसरलेला noindex हाच यामागील दोष असतो.
पेज इंडेक्सिंग काय तपासते?
हे साधन दोन गोष्टी एकत्र करते: एक वस्तुस्थिती (पृष्ठ सध्या Google आहे की नाही) आणि एक निदान (ते तत्त्वतः तिथे पोहोचू शकते की नाही).
| परीक्षा | तो कशाकडे बघत आहे? | हे का आवश्यक आहे? |
|---|---|---|
| निर्देशांकातील उपलब्धता | वास्तविक साइट: Google मध्ये या URL साठी शोधा | मुख्य प्रश्नाचे उत्तर: Google हे पान दिसते का? |
| मेटा रोबोट्स | कोडमधील <meta name="robots" content="noindex"> टॅग | इंडेक्सिंगवर थेट बंदी हे सर्वात सामान्य कारण आहे. |
| एक्स-रोबोट्स-टॅग | तीच बंदी, पण HTTP रिस्पॉन्स हेडरमध्ये | ते पेज कोडमध्ये दिसत नाही आणि सहजपणे नजरेतून सुटू शकते. |
| robots.txt | हा पत्ता 'डिसअलो' नियमाद्वारे ब्लॉक केला आहे का? | रोबोट एखादे पान सरकवून वाचू शकत नाही. |
| कॅनोनिकल | कॅनॉनिकल लिंक कोणत्या पत्त्याकडे निर्देशित करतो? | दुसऱ्या URL साठी कॅनॉनिकल - वेगळे पृष्ठ अनुक्रमित करण्याची विनंती |
| sitemap.xml | पत्ता साईटमॅपवर आहे का? | साइटमॅप आणि लिंक्सशिवाय, Google त्या पेजबद्दल बराच काळ माहिती नसेल. |
| निकाल | कारणे आणि उपायांसह सारांश | नेमकं काय दुरुस्त करायचं आहे? |
एखादे पान Google अनुक्रमित (इंडेक्स) झाले आहे की नाही हे कसे तपासावे?
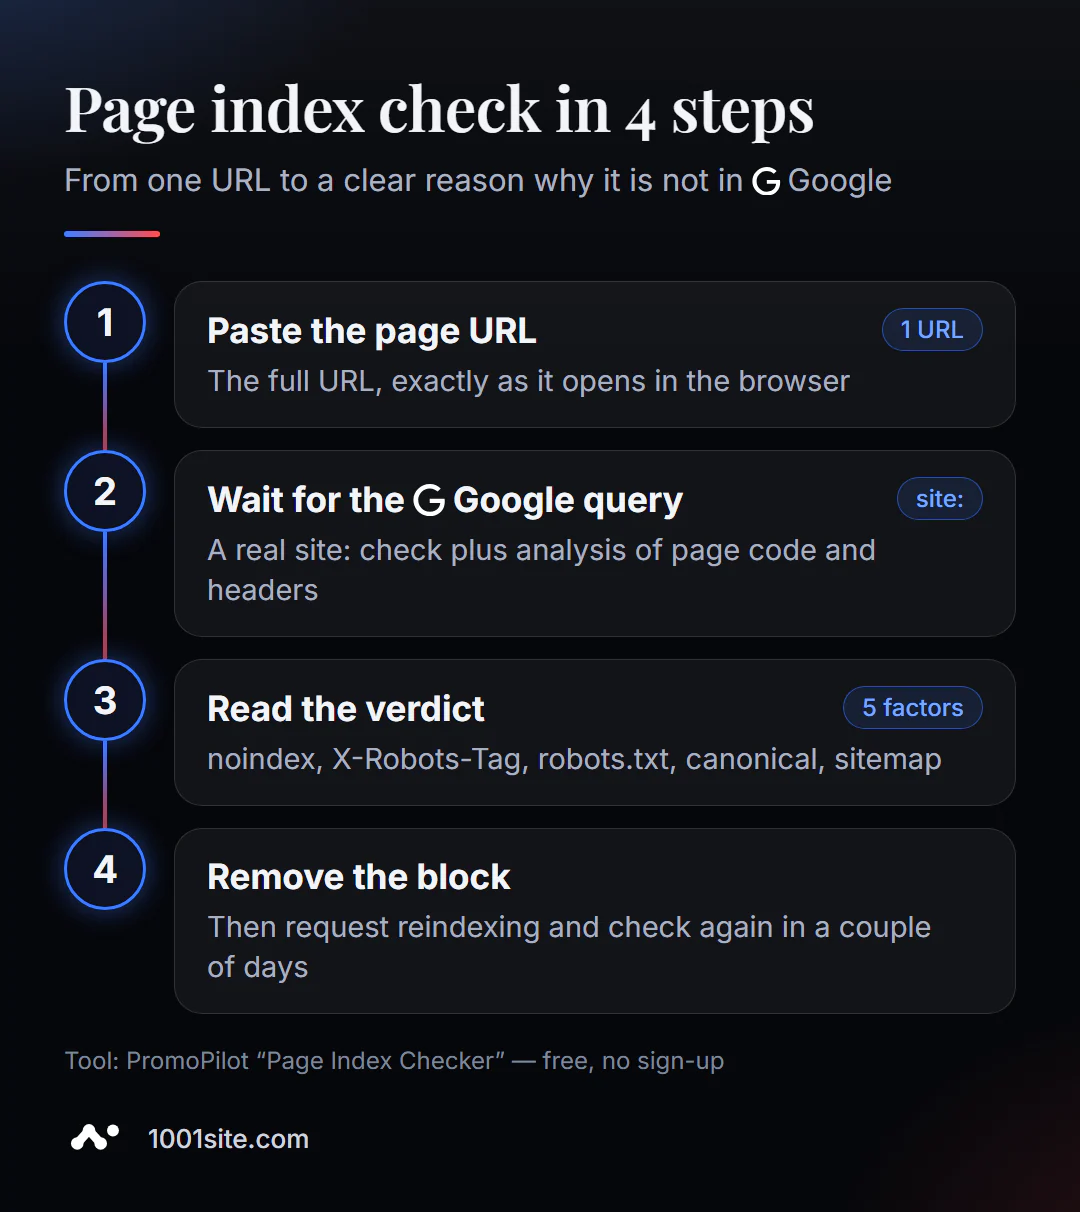
- पृष्ठ अनुक्रमणिका तपासक उघडा.
- संपूर्ण पृष्ठाचा पत्ता, प्रोटोकॉलसह आणि ब्राउझरमध्ये जसा दिसतो तसाच पेस्ट करा:
https://example.com/new-page. - "इंडेक्सिंग तपासा" वर क्लिक करा आणि Google घटक क्वेरी करून त्यांचे विश्लेषण करू द्या.
- "इंडेक्समध्ये आहे" किंवा "इंडेक्समध्ये नाही" हा निकाल आणि सापडलेल्या ब्लॉक्सची यादी वाचा.
- कारण दूर करा आणि काही दिवसांनी पुन्हा तपासा.
टूल पेज असे दिसते: पत्त्याचे फील्ड, आजच्या मोफत तपासण्यांची संख्या आणि काय विश्लेषण केले जात आहे याची यादी.
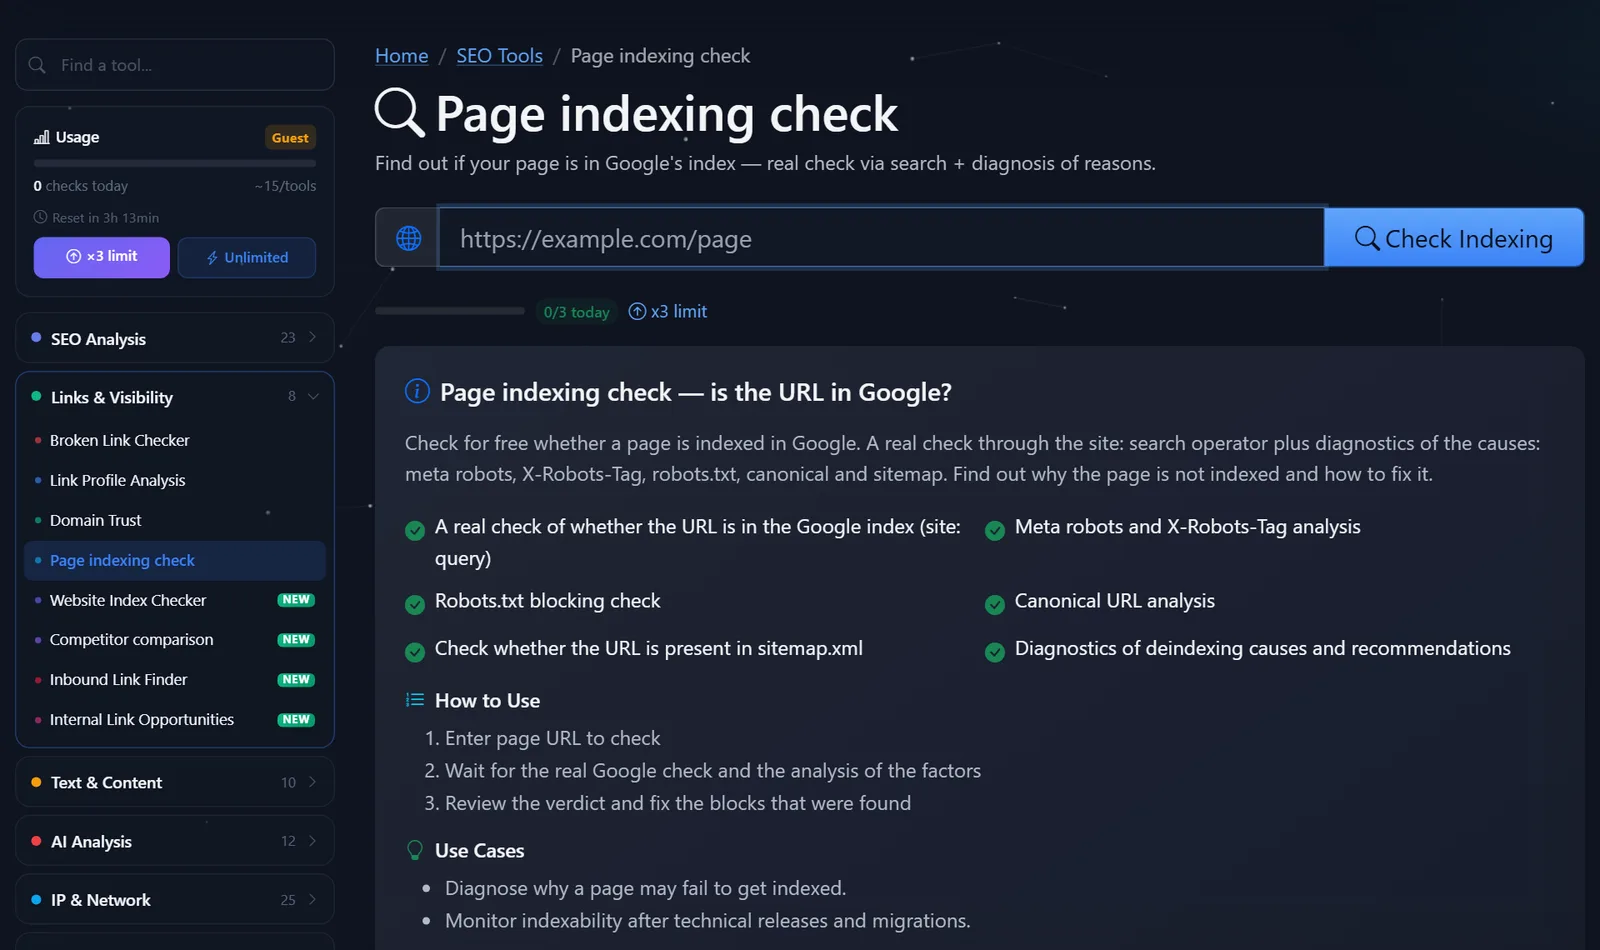
उदाहरणादाखल निकाल: https://example.com/new-page हे पान इंडेक्स होण्यापासून अवरोधित केले आहे, कारण कोडमध्ये 'noindex' हा मेटा आहे आणि कॅनॉनिकल URL एका वेगळ्या URL कडे निर्देशित करतो. एकाच वेळी दोन कारणे, आणि दोन्ही टेम्पलेटमध्ये आहेत.
पेज इंडेक्स का होत नाहीये आणि मी सर्वात आधी काय दुरुस्त करावे?
थेट बंदींपासून ते सौम्य बंदींपर्यंत, कारणांचा या क्रमाने विचार करा.
- मेटा रोबोट्स किंवा एक्स-रोबोट्स-टॅगमध्ये 'नोइंडेक्स' (noindex) असल्यास, ते काढून टाका. एक सामान्य परिस्थिती अशी आहे की: डेव्हलपमेंट दरम्यान, CMS मध्ये "साइट सर्च इंजिनपासून लपवा" हा पर्याय सक्षम (enabled) केला जातो आणि नंतर तो अक्षम (disabled) करायला विसरले जाते. एक्स-रोबोट्स-टॅगसाठी, तुमच्या सर्व्हर सेटिंग्ज, CDN किंवा SEO प्लगइन तपासा.
- robots.txt मध्ये परवानगी नाकारा.
Disallow: /blog/सारखा नियम संपूर्ण विभाग बंद करतो. एक बारकावा: जर एखादे पान robots.txt मध्ये बंद केले असेल, तर Google त्यावरचे "noindex" वाचू शकत नाही. म्हणून, ते इंडेक्समधून काढून टाकण्यासाठी, तुम्हाला एक उघडा robots.txt आणि "noindex" आवश्यक आहे, आणि त्याला इंडेक्स करण्यासाठी, फक्त "Disallow" टॅग काढून टाका. - कॅनॉनिकल वेगळ्या पत्त्यावर निर्देशित आहे. जर पृष्ठ अद्वितीय असेल, तर कॅनॉनिकलने स्वतः त्या पृष्ठाकडेच निर्देशित केले पाहिजे. त्रुटी अनेकदा टेम्पलेटमध्ये असते: कॅनॉनिकल असलेली सर्व उत्पादने श्रेणीकडे, तर सर्व लेख ब्लॉगच्या मुख्यपृष्ठाकडे निर्देशित असतात.
- ते साईटमॅपमध्ये नाही आणि त्याला कोणतीही लिंक नाही. ते एक अनाथ पान आहे ज्याबद्दल Google माहिती नाही. ते तुमच्या sitemap.xml मध्ये जोडा आणि आधीच अनुक्रमित (indexed) असलेल्या पानांवरून—म्हणजेच मेनू, श्रेणी आणि संबंधित लेखांमधून—लिंक्स जोडा.
- सर्व काही उघडे आहे, पण ते पान दिसत नाही. याचा अर्थ असा की, Google ते पाहिले आणि त्याचा समावेश न करण्याचा निर्णय घेतला—सहसा अपुऱ्या किंवा पुनरावृत्त मजकुरामुळे. केवळ पानामध्येच सुधारणा केल्याने मदत होऊ शकते.
स्वतःहून एखादा ब्लॉक पटकन कसा शोधायचा. पेज उघडा, Ctrl+U दाबा आणि कोडमध्ये noindex व canonical शोधा. X-Robots-Tag हेडर ब्राउझरच्या डेव्हलपर टूल्समध्ये (नेटवर्क टॅब → डॉक्युमेंट रिस्पॉन्स → हेडर्स) दिसतो. ваш-домен/robots.txt येथे robots.txt उघडा — पेजच्या ॲड्रेसच्या सुरुवातीशी जुळणारे Disallow नियम शोधा. हे टूल तुमच्यासाठी हे सर्व करते, पण कुठे शोधायचे हे माहित असणे उपयुक्त ठरते: यामुळे बदल खरोखर लागू झाला आहे की नाही हे तपासणे सोपे होते.
पॅरामीटर्स आणि फिल्टर्स असलेली पृष्ठे एक विशेष बाब आहे: ?sort=price, ?color=red, UTM टॅग्ज. यांना सहसा इंडेक्स करण्याची आवश्यकता नसते; कॅनॉनिकल लिंक मुख्य आवृत्तीशी जोडलेली असेल तर ते सर्वोत्तम असते. जर तुम्ही असा URL तपासला आणि श्रेणीशी जोडलेल्या कॅनॉनिकल लिंकसह "not indexed" असे दिसले, तर सर्व काही अपेक्षेप्रमाणे काम करत आहे.
एकदा तांत्रिक समस्यांचे निराकरण झाले की, तुम्ही प्रक्रिया जलद करू शकता: सर्च कन्सोलमधील URL तपासणी साधनाचा वापर करून तुमच्या सत्यापित साइटचा URL पुनर्निर्देशनासाठी सादर करा. तथापि, ही एक विनंती आहे, हमी नाही: नवीन पृष्ठांना अनुक्रमित होण्यासाठी काही दिवसांपासून ते काही आठवड्यांपर्यंत वेळ लागू शकतो.
तुलना: प्रोमोपायलट पेज इंडेक्सिंग तपासणी आणि पर्याय
| साधन | काय मोफत आहे? | निर्बंध | हे कोणासाठी योग्य आहे? |
|---|---|---|---|
| प्रोमोपायलट — पृष्ठ अनुक्रमणिका तपासक | इंडेक्सिंग फॅक्ट + डायग्नोस्टिक्स: नोइंडेक्स, एक्स-रोबोट्स-टॅग, रोबोट्स.txt, कॅनॉनिकल, साईटमॅप | सार्वजनिक सिग्नल, दैनंदिन तपासणी मर्यादा | सर्च कन्सोलचा ॲक्सेस नसताना, दुसऱ्याच्या पेजसह कोणतेही पेज. |
| शोध कन्सोल - यूआरएल तपासक | अचूक इंडेक्सिंग स्थिती, पुनर्इंडेक्सिंग विनंती | फक्त तुमच्या सत्यापित साइटसाठी | वेबसाइट मालकांसाठी - सत्याचा मुख्य स्रोत |
| मॅन्युअल साइट: Google क्वेरी | निकालांवर एक नजर | कारणांचे निदान केल्याशिवाय, निकाल चुकीचा असू शकतो. | अगदी पहिला अंदाज |
| स्क्रिमिंग फ्रॉग एसईओ स्पायडर | क्रॉलिंग दरम्यान पृष्ठाची अनुक्रमणिकाक्षमता | बंदी दाखवते पण Google उपस्थिती दाखवत नाही; इन्स्टॉलेशन आवश्यक आहे. | मोठ्या प्रमाणावर साइट ब्लॉक करण्याची तपासणी |
निष्कर्ष: सर्च कन्सोल हे तुमच्या वेबसाइटसाठी एक मापदंड आहे, परंतु तुम्हाला त्याचा ॲक्सेस आवश्यक आहे. जेव्हा ॲक्सेस उपलब्ध नसतो (उदाहरणार्थ, क्लायंटच्या साइटवर, जुन्या प्रोजेक्टवर किंवा प्रतिस्पर्धकाच्या पेजवर) किंवा जेव्हा तुम्हाला तांत्रिक अडथळा आहे की नाही हे त्वरित तपासायचे असते, तेव्हा ऑनलाइन तपासणी सोयीस्कर ठरते.
प्रोमोपायलटमध्ये आणखी ८७ मोफत एसईओ टूल्स आहेत. जर तुम्ही फक्त एका पानाबद्दल नाही, तर तुमच्या संपूर्ण वेबसाइटबद्दल विचारत असाल—म्हणजे, डोमेनची किती पाने Google रँक होतात आणि साईटमॅपच्या किती टक्के भागात ते रँक होते—तर त्यासाठी एक वेगळी साईट इंडेक्सेशन तपासणी आहे, जी या विभागातील पुढील लेखात समाविष्ट आहे. robots.txt विश्लेषक तुम्हाला robots.txt चे नियम समजून घेण्यास मदत करतो.
पृष्ठ अनुक्रमणिका तपासणीच्या मर्यादा?
हे टूल सार्वजनिक सिग्नल वापरते आणि सर्च कन्सोलमधील URL तपासणी टूलमधील डेटाची जागा घेत नाही: केवळ साइट मालकच Google वगळण्याची नेमकी स्थिती आणि कारणे पाहू शकतो.
तात्पुरते बॉट ब्लॉक्स—जसे की DDoS संरक्षण, कॅप्चा (CAPTCHA) आणि रेट लिमिटिंग—यांचा अचूकतेवर परिणाम होऊ शकतो: जर टूल एखादे पेज उघडण्यात अयशस्वी झाले, तर मेटा रोबोट्स आणि कॅनॉनिकल निकाल अपूर्ण असतील. तसेच, एखादे अलीकडील पेज कदाचित आधीच इंडेक्स केलेले असेल, परंतु 'site: query' ते लगेच दाखवत नाही. जर निकाल "इंडेक्स केलेले नाही" असा असेल आणि कोणतेही ब्लॉक्स नसतील, तर दोन दिवसांनी पुन्हा तपासा.
शेवटी, हे टूल पेज बाहेरून तपासते आणि Google त्याच्या गुणवत्तेचे मूल्यांकन कसे केले आहे हे त्याला माहीत नसते. "क्रॉल केले, पण अद्याप इंडेक्स केलेले नाही" ही स्थिती केवळ सर्च कन्सोलमध्ये दिसते—आणि ती कोडद्वारे नव्हे, तर पेजच्या मजकुराद्वारे हाताळली जाते.
एखादे मोफत साधन केव्हा पुरेसे नसते?
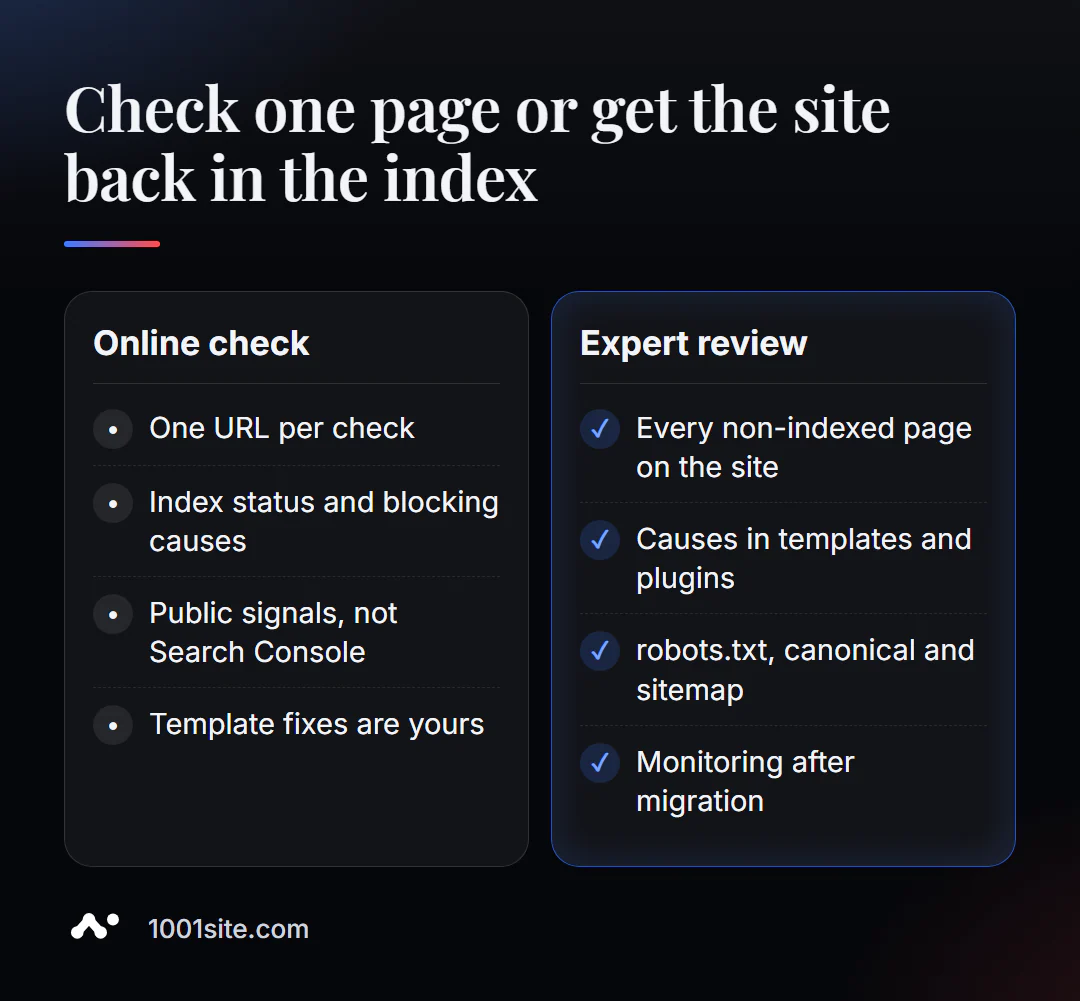
'noindex' विसरलेल्या एका पानाचे काम करायला पाच मिनिटे लागतात. पण गोष्टी अधिक गुंतागुंतीच्या असू शकतात. तुम्हाला तज्ञाची गरज आहे, जर:
- अनेक पानांची अनुक्रमणिका नाही आणि कोणतेही स्पष्ट निर्बंध नाहीत;
- कॅनॉनिकल, नोइंडेक्स किंवा रोबोट्स.txt हे प्लगइन किंवा टेम्पलेटद्वारे तयार केले जातात आणि संपादनानंतर "परत केले" जातात;
- स्थलांतर केल्यानंतर, अनुक्रमणिकेतून पृष्ठे काढून टाकण्यात आली आणि नवीन पृष्ठे दिसत नाहीत;
- इंडेक्समध्ये पृष्ठे आहेत, परंतु Google वेगळाच पत्ता प्रमाणभूत म्हणून निवडतो.
मी तुमच्या वेबसाइटसाठी काय करू शकेन?
माझं नाव वलेरी डॅन्युक आहे, मी एक डेव्हलपर आणि एसईओ तज्ञ असून मला १२ वर्षांचा अनुभव आहे आणि २०० हून अधिक ग्राहक आहेत. इंडेक्सिंगच्या समस्या हे माझ्याकडे येण्यामागील सर्वात सामान्य कारणांपैकी एक आहे.
एसईओ आणि जाहिरात
- टर्नकी एसईओ ऑडिट: पेजेस इंडेक्स का होत नाहीत हे मी शोधून काढतो आणि टेम्प्लेट्स, robots.txt, canonical, व sitemap दुरुस्त करतो.
- तात्काळ अनुक्रमित होणारी सामग्री: एआय एजंट्सद्वारे समर्थित ऑटोब्लॉग योग्य मार्कअप आणि साइटमॅप्ससह लेख प्रकाशित करतो.
- भाषा आवृत्त्यांची सूची तयार करणे - अनुवादकाशिवाय बहुभाषिक साइट कशी तयार करावी याच्या विश्लेषणात.
वेबसाइट्स आणि ऑनलाइन स्टोअर्स
- रातोरात लॉन्च झालेल्या नवीन उत्पादनाचे लँडिंग पेज पहिल्या मिनिटापासून इंडेक्सिंगसाठी खुले असते.
- 1001site वर काही मिनिटांत तुमच्या आवडत्या वेबसाइटच्या शैलीत वेबसाइट मिळवा: सर्व्हर रेंडरिंग, साइटमॅप आणि मार्कअप स्वयंचलितपणे कॉन्फिगर केले जातात.
- Google शोधलेल्या कार्ड्सच्या साहाय्याने Instagram वेबसाइटवर स्टोअर स्थानांतरित करणे.
CRM, लेखांकन आणि ऑटोमेशन
Google सूचीबद्ध नसलेल्या पेजचा पत्ता मला Telegram पाठवा - मी तुम्हाला कारण कुठे शोधायचे ते सांगेन.
निकाल
- एखाद्या पेजचे इंडेक्सेशन तपासल्याने दोन प्रश्नांची उत्तरे मिळतात: URL Google आहे की नाही आणि त्याला तिथे पोहोचण्यापासून काय रोखत आहे.
- वारंवारतेनुसार कारणे: noindex (कोड किंवा हेडरमध्ये), robots.txt, दुसऱ्याच्या पत्त्यावर कॅनॉनिकल असणे, साइटमॅप आणि लिंक्स नसलेले अनाथ पृष्ठ.
- ते दुरुस्त केल्यावर, सर्च कन्सोलमध्ये पुनर्निर्देशनासाठी URL सबमिट करा आणि काही दिवसांनी पुन्हा तपासा.
- जर डझनभर पाने अनुक्रमित (indexed) नसतील, तर ऑडिट करणे आवश्यक आहे, आणि गुंतागुंतीचे टेम्पलेट्स असलेली जुनी साइट कधीकधी 1001site वर पुन्हा तयार करणे सोपे असते.
शोध परिणामांमधून 'गायब' झालेले पृष्ठ तपासा — एका मिनिटापेक्षा कमी वेळात कारणासह निकाल दिसेल.
स्रोत
- प्रोमोपायलटच्या "पेज इंडेक्सिंग चेक" टूलचे पान — तपासण्यांची यादी, उदाहरण आणि मर्यादा.
- Google सर्च कन्सोल मदत - URL तपासणी साधन.
- Google सर्च सेंट्रल - noindex वापरून इंडेक्सिंग ब्लॉक करा.
- Google सर्च सेंट्रल - कॅनॉनिकल यूआरएल आणि डुप्लिकेट पृष्ठे.