Коротка відповідь: щоб перевірити robots.txt онлайн, введіть домен в Аналіз robots.txt PromoPilot і натисніть "Аналізувати". Інструмент сам завантажить файл, розбере всі директиви (Allow, Disallow, Crawl-delay, Sitemap), покаже блоки User-agent та роботів, на яких вони націлені, знайде синтаксичні помилки та ризиковані правила, перевірить доступність критичних URL та дасть рекомендації. Безкоштовно, без реєстрації.
Найдорожчий рядок, який я зустрічав у чужому robots.txt — Disallow: /, що залишився після розробки. Сайт запустили, рекламу сплатили, а органіка три тижні стояла на нулі, бо роботам заборонили заходити на всі сторінки.
Що перевіряє аналіз robots.txt?
Robots.txt - короткий текстовий файл в корені сайту, але помилитися в ньому легко: одна зайва коса риса змінює зміст правила. Інструмент читає файл так, як його читають пошукові роботи.
| Що дивиться інструмент | приклад | Навіщо це для SEO |
|---|---|---|
| Усі директиви | Allow, Disallow, Crawl-delay, Sitemap | Видно, що саме дозволено та заборонено |
| Блоки User-agent | User-agent: *, User-agent: Google bot | Правила для конкретного робота перекривають загальні |
| Посилання на Sitemap | Sitemap: https://example.com/sitemap.xml | Робот швидше знаходить мапу сайту |
| Синтаксичні помилки | Dissalow, правило без блоку User-agent | Неправильний рядок просто ігнорується |
| Ризиковані правила | Disallow: /, закриті /catalog/, CSS та JS | Важливі сторінки випадають із сканування |
| Доступність критичних URL | Головна, основні розділи | Підтвердження, що ключові сторінки відкриті |
Приклад результату з опису інструменту: «Знайдено 2 потенційно ризиковані правила Disallow та 1 відсутня директива Sitemap». Саме такі знахідки й варті уваги насамперед.
Як перевірити robots.txt онлайн?
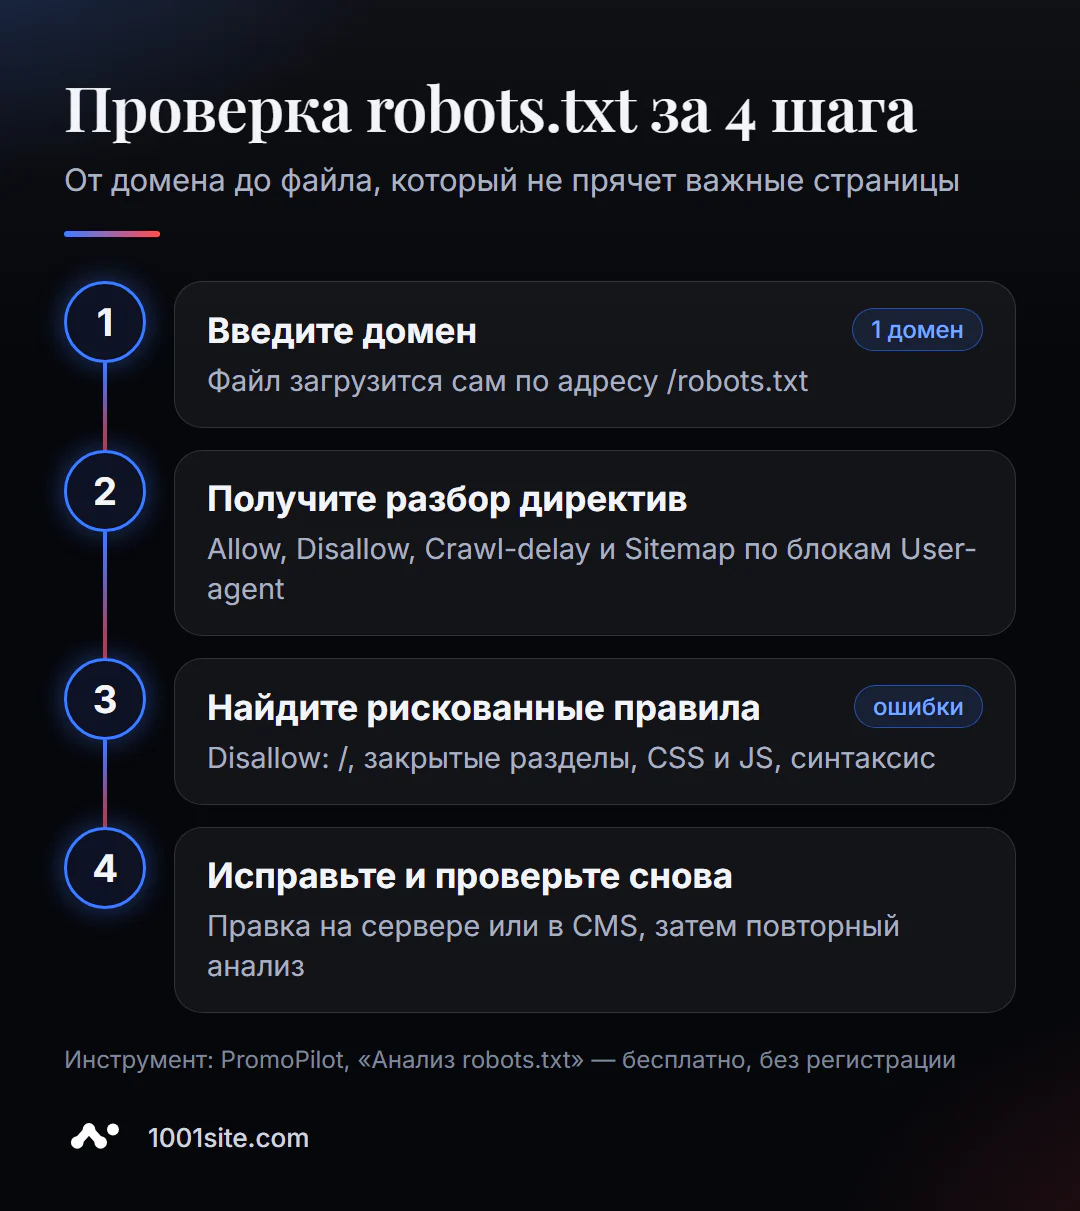
- Відкрийте інструмент. Аналіз robots.txt працює у браузері.
- Введіть домен -
https://example.com. Файл завантажиться автоматично на адресу/robots.txt. - Натисніть "Аналізувати".
- Вивчіть список директив по блокам User-agent.
- Розберіть помилки та ризиковані правила – це головне у звіті.
- Виправте файл на сервері або в налаштуваннях CMS та запустіть перевірку повторно.
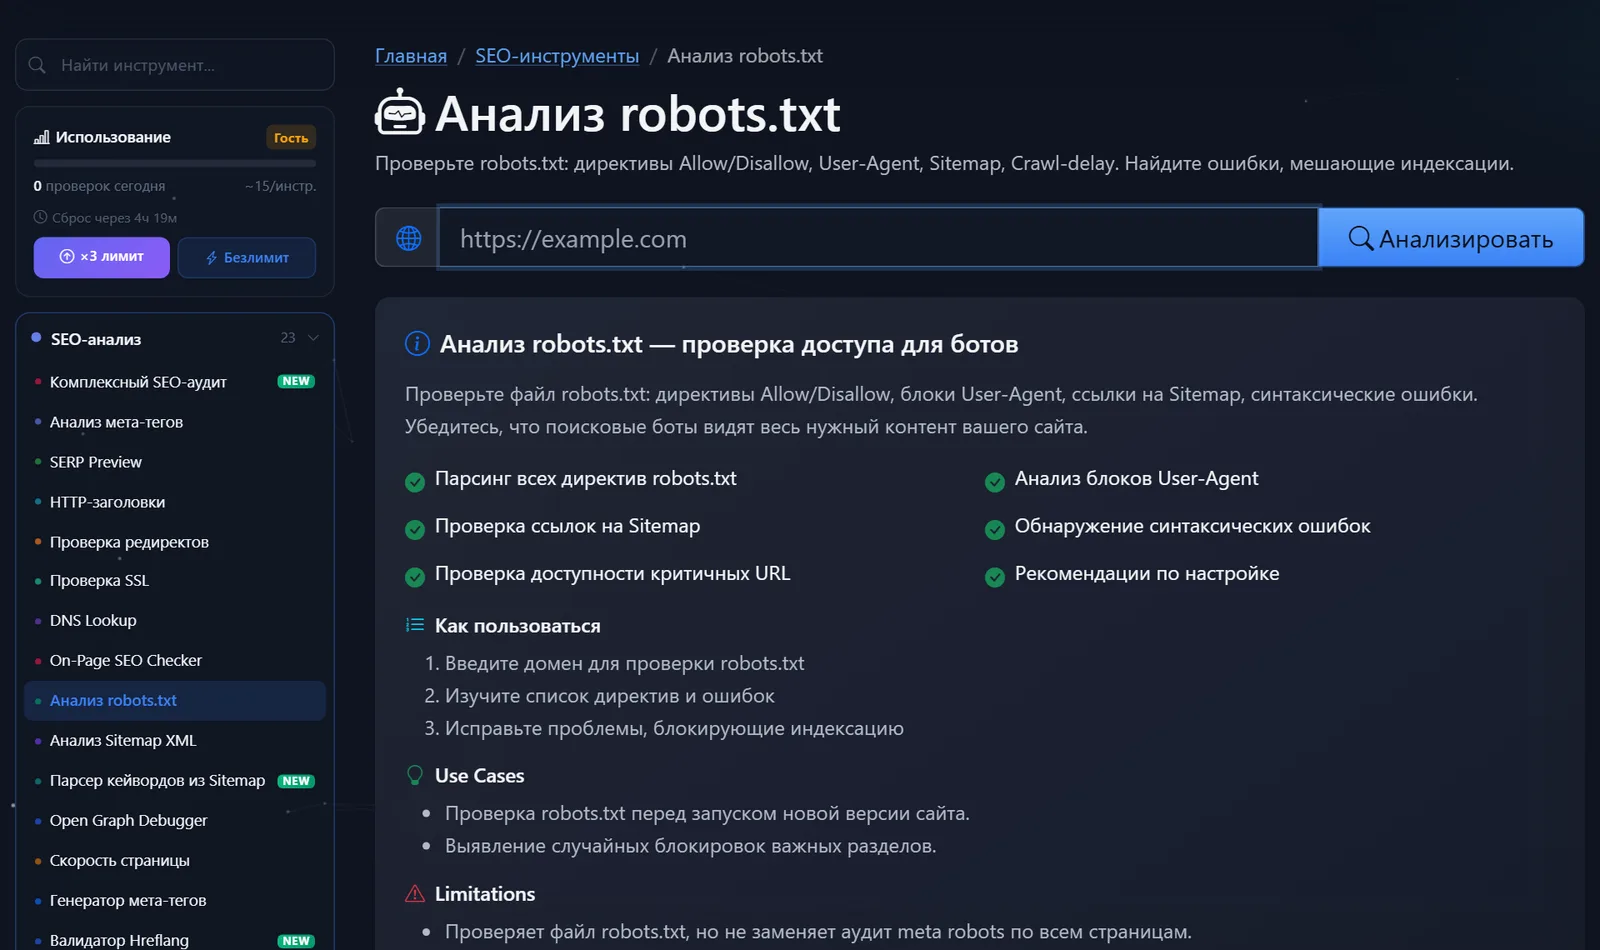
Сторінка інструменту: поле для адреси, кнопка «Аналізувати» та опис – що перевіряється, сценарії та обмеження.
Перевіряйте robots.txt у двох обов'язкових випадках: перед запуском нової версії сайту та після будь-якого переїзду. Саме тоді тестові заборони найчастіше «їдуть» до робочої версії. Корисно перевірити і файл конкурента: по закритих розділах видно, які сторінки вважає службовими і як влаштований його каталог.
Як читати результат та що виправити першим?
Рухайтеся від правил, які закривають весь сайт до косметики.
Disallow: /у блоціUser-agent: *. Закрито весь сайт. Якщо це не тестова версія, видаляйте рядок негайно.- Закрито важливі розділи.
Disallow: /catalogзакриває не тільки каталог, а й усе, що починається з цих символів, наприклад/catalog-sale/. Правила працюють на початку шляху, і регістр літер важливий. - Закриті CSS, JS та картинки. Правило на кшталт
Disallow: /wp-content/заважає Google побачити сторінку так, як її бачить людина. Робот повинен завантажувати стилі та скрипти. - Немає рядка Sitemap або він веде на 404. Вкажіть повну адресу картки сайту з протоколом.
- Синтаксису. Друкарські помилки в назвах директив, правила поза блоком User-agent, порожні рядки всередині блоку — невірні рядки роботи ігнорують, і правило мовчки не працює.
- Директиви, які Google не підтримує.
Crawl-delayGoogle bot ігнорує, аNoindexу robots.txt Google не підтримує. Якщо ви на них розраховуєте - правило не діє.
Приклад правильного файлу для сайту на WordPress:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /?s=
Disallow: /cart/
Disallow: /checkout/

Sitemap: https://example.com/sitemap.xml
Закрито адмінку, внутрішній пошук та службові сторінки магазину, відкрито AJAX-обробник, без якого ламаються частини сайту, та вказано карту сайту. Решта за замовчуванням дозволена.
Як зрозуміти, чи відкрита конкретна адреса, якщо правил багато? Google застосовує саме конкретне правило - те, у якого шлях довший. Якщо у файлі є Disallow: /blog/ і Allow: /blog/seo/, то сторінку /blog/seo/proverka/ відкрито, а /blog/news/ закрито. При рівній довжині перемагає дозвільне правило. Зірочка * замінює будь-яку послідовність символів, а $ означає кінець адреси: Disallow: /*.pdf$ закриває всі PDF-файли, але не сторінку /pdf-guide/.
Ще одна часта знахідка - кілька блоків для одного і того ж робота або загальний блок, який «перекривається» окремим. Якщо файл User-agent: Google bot, то Google bot читає лише цей блок і повністю ігнорує правила з User-agent: *. Тому всі потрібні заборони доведеться продублювати у його блоці.
Окрема тема 2026 - ІІ-краулери. Блок User-agent: GPTBot з Disallow: / забороняє OpenAI оминати сайт. Це ваше рішення, але врахуйте: якщо сайт закритий для ІІ-ботів, помічникам складніше його рекомендувати.
Порівняння: аналіз robots.txt у PromoPilot та альтернативи
| Інструмент | Що безкоштовно | Обмеження | Кому підходить |
|---|---|---|---|
| PromoPilot - Аналіз robots.txt | Розбір директив та блоків, помилки, ризиковані правила, рекомендації | Тільки robots.txt, без метатегів сторінок | Швидко перевірити свій чи чужий сайт |
| Google Search Console - звіт robots.txt | Як Google отримав ваш файл, коли і з якими помилками | Тільки для свого підтвердженого сайту | Власникам сайтів |
| Screaming Frog SEO Spider | Обхід сайту з урахуванням robots.txt, перевірка своїх правил | Програму потрібно встановити | Технічний аудит |
| Ручна перевірка у браузері | Відкрити /robots.txt та прочитати | Без розбору помилок та підказок | Якщо файл із трьох рядків |
Висновок: Search Console показує, як файл бачить Google, але лише для вашого сайту. Онлайн-аналіз працює з будь-яким доменом та пояснює, що не так.
Аналіз robots.txt - один з 87 безкоштовних SEO-інструментів PromoPilot. Якщо файлу немає або його простіше переписати з нуля, загляньте в сусідню статтю розділу про генератор robots.txt - там збираємо файл у візуальному конструкторі. Для перевірки самої карти сайту є окремий аналіз sitemap.xml.
Обмеження: що перевірка robots.txt не замінить?
Інструмент перевіряє лише файл robots.txt і не замінює аудит метатегів robots на рівні сторінок. Сторінка може бути відкрита в robots.txt, але закрита метатегом noindex або заголовком X-Robots-Tag - такі заборони шукайте перевіркою сторінки або повним аудитом.
Різні роботи по-різному трактують нестандартні директиви. Те, що підтримує одна пошукова система, інший мовчки пропустить. Спирайтеся на стандартні User-agent, Allow, Disallow і Sitemap – їх розуміють усі великі пошукові системи.
І пам'ятайте: robots.txt – не захист. Він чемно просить роботів не заходити, але не закриває доступ. Адмінку та особисті дані захищають паролем, а не рядком Disallow. Більше того, robots.txt відкрито всім: перераховуючи в ньому «секретні» розділи, ви самі показуєте їх цікавим.
Коли безкоштовний інструмент мало?
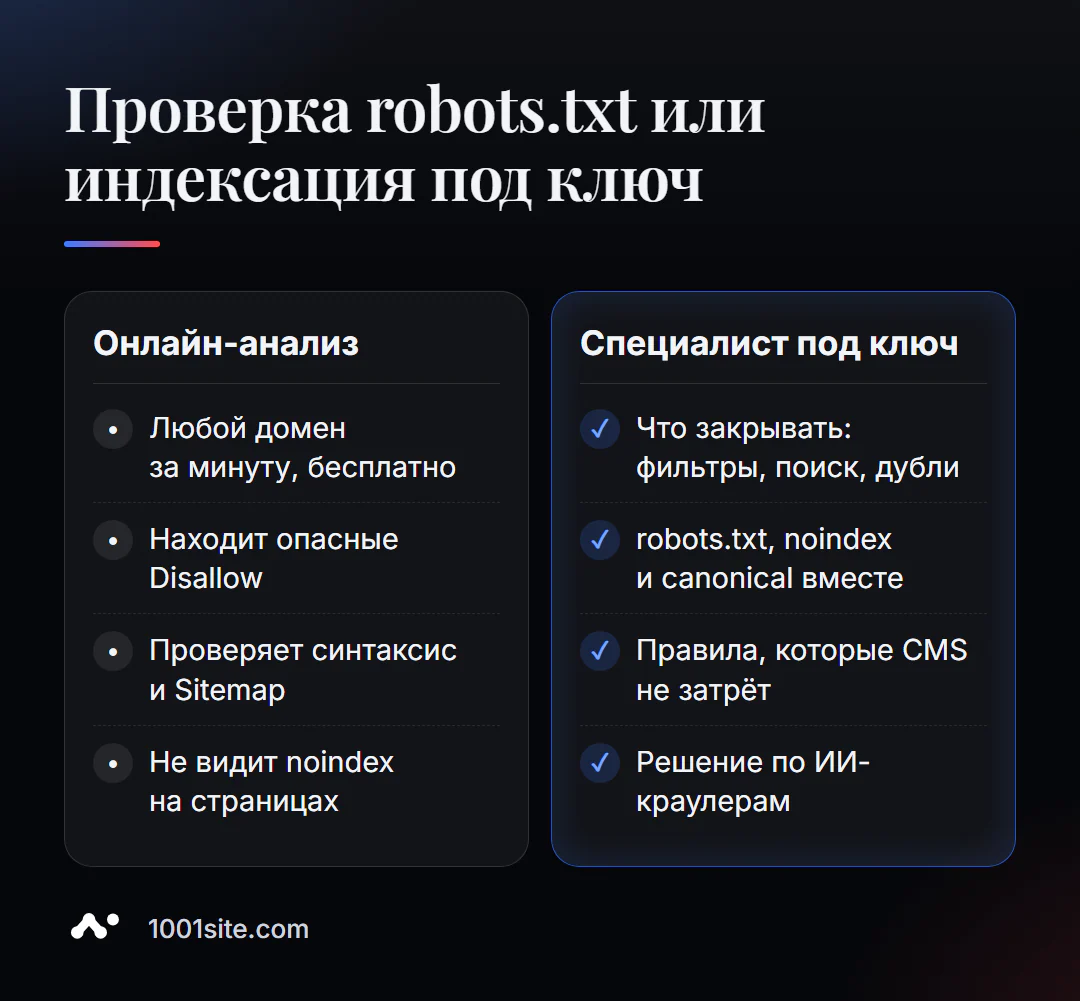
Знайти ризиковане правило - півсправи. Вирішити, які розділи закривати вже стратегія. Фахівець потрібен, якщо:
- у магазину тисячі сторінок фільтрів та сортувань, і незрозуміло, що з них закривати;
- сайт випав з пошуку, а robots.txt «начебто в порядку»;
- robots.txt генерує CMS або плагін, і ваші редагування перезаписуються;
- потрібно вирішити, чи пускати ІІ-краулери, і як це позначиться на видимості в помічниках.
Що я можу зробити для вашого сайту?
Мене звуть Валерій Данюк, я розробник та SEO-фахівець: 12 років, 200+ клієнтів. Robots.txt, метатеги та карта сайту – перше, що я перевіряю в кожному аудиті.
SEO та просування
- SEO-аудит під ключ: robots.txt, noindex, canonical, sitemap і реальна індексація - з виправленнями.
- Автоблог з ІІ-агентами — редакція без людей, яка публікує статті та одразу відкриває їх для індексації.
- GEO: як готель потрапив у рекомендації ChatGPT, Gemini та Perplexity - кейс про видимість у відповідях ІІ-асистентів.
Сайти та інтернет-магазини
- Сайт на WordPress з ІІ-помічником за 299 € - з правильним robots.txt та картою сайту з першого дня.
- Сайт на 1001site: sitemap, структуровані дані та індексація ІІ-ботами налаштовані автоматично.
CRM, облік та автоматизація
- ERP, сайт і Telegram -бот з ІІ для авторозбірки за 6 днів.
- Дропшиппінг-платформа з магазинами партнерів – де кожному магазину потрібен свій коректний robots.txt.
Усі кейси — у портфоліо. Надішліть адресу в Telegram - прочитаю ваш robots.txt і скажу, чи не закрито зайве.
Підсумок
- Перевірка robots.txt онлайн за хвилину знаходить правила, які ховають сайт або розділи від роботів.
- Чиніть по порядку:
Disallow: /→ закриті розділи → CSS та JS → Sitemap → синтаксис. - Disallow не прибирає сторінку з індексу – для цього потрібен
noindexна відкритій сторінці. - Якщо robots.txt генерує CMS, а правки не тримаються, простіше довірити налаштування фахівця або перейти на 1001site, де індексація налаштована з коробки.
Перевірте свій файл прямо зараз: запустіть безкоштовний аналіз robots.txt, а якщо знайдуться ризиковані правила - напишіть мені Telegram.
Джерела
- Сторінка інструменту «Аналіз robots.txt» PromoPilot – перевірки, приклад результату та питання сторінки.
- Google Search Central — введення в robots.txt та директиви, що підтримуються.
- Довідка Google Search Console — звіт про файл robots.txt.