Het korte antwoord: om te controleren of een pagina in Google is geïndexeerd, plak je het adres in de Page Indexing Checker van PromoPilot. De tool voert een echte site-aanvraag uit bij Google en vertelt je of de URL is geïndexeerd. Zo niet, dan controleert de tool op eventuele problemen, zoals ontbrekende meta- en X-Robots-tags, een niet-toegestane robots.txt-tag, canonicalisatie naar een andere URL of een ontbrekende sitemap.xml. Vervolgens geeft de tool een oordeel met de oorzaken en mogelijke oplossingen. De tool is gratis en vereist geen registratie. Hieronder lees je hoe je het oordeel kunt lezen en wat je aan elk probleem kunt doen.
"De pagina is een maand geleden gepubliceerd, maar staat niet in Google " is de meest gestelde vraag die ik krijg. In de helft van de gevallen is de boosdoener een vergeten noindex, die is achtergebleven na de ontwikkeling.
Wat controleert pagina-indexering?
De tool combineert twee dingen: een feit (of de pagina momenteel in Google staat) en een diagnose (of de pagina er in principe in kan komen).
| Inspectie | Waar kijkt hij naar? | Waarom is dit nodig? |
|---|---|---|
| Beschikbaarheid in de index | Een echte website: zoek deze URL in Google | Het antwoord op de belangrijkste vraag: ziet Google de pagina? |
| meta-robots | De <meta name="robots" content="noindex"> tag in de code | Een direct verbod op indexering is de meest voorkomende reden. |
| X-Robots-Tag | Hetzelfde verbod, maar dan in de HTTP-antwoordheader. | Het is niet zichtbaar in de paginacode en kan gemakkelijk over het hoofd worden gezien. |
| robots.txt | Wordt het adres geblokkeerd door een 'Disallow'-regel? | Een robot kan geen pagina doorzoeken en lezen. |
| canoniek | Naar welk adres verwijst de canonieke link? | Canonical naar een andere URL - Verzoek om een andere pagina te indexeren |
| sitemap.xml | Staat het adres op de sitemap? | Zonder sitemap en links kan Google de pagina lange tijd niet vinden. |
| Uitspraak | Samenvatting met redenen en oplossingen | Wat moet er precies gerepareerd worden? |
Hoe controleer ik of een pagina door Google is geïndexeerd?
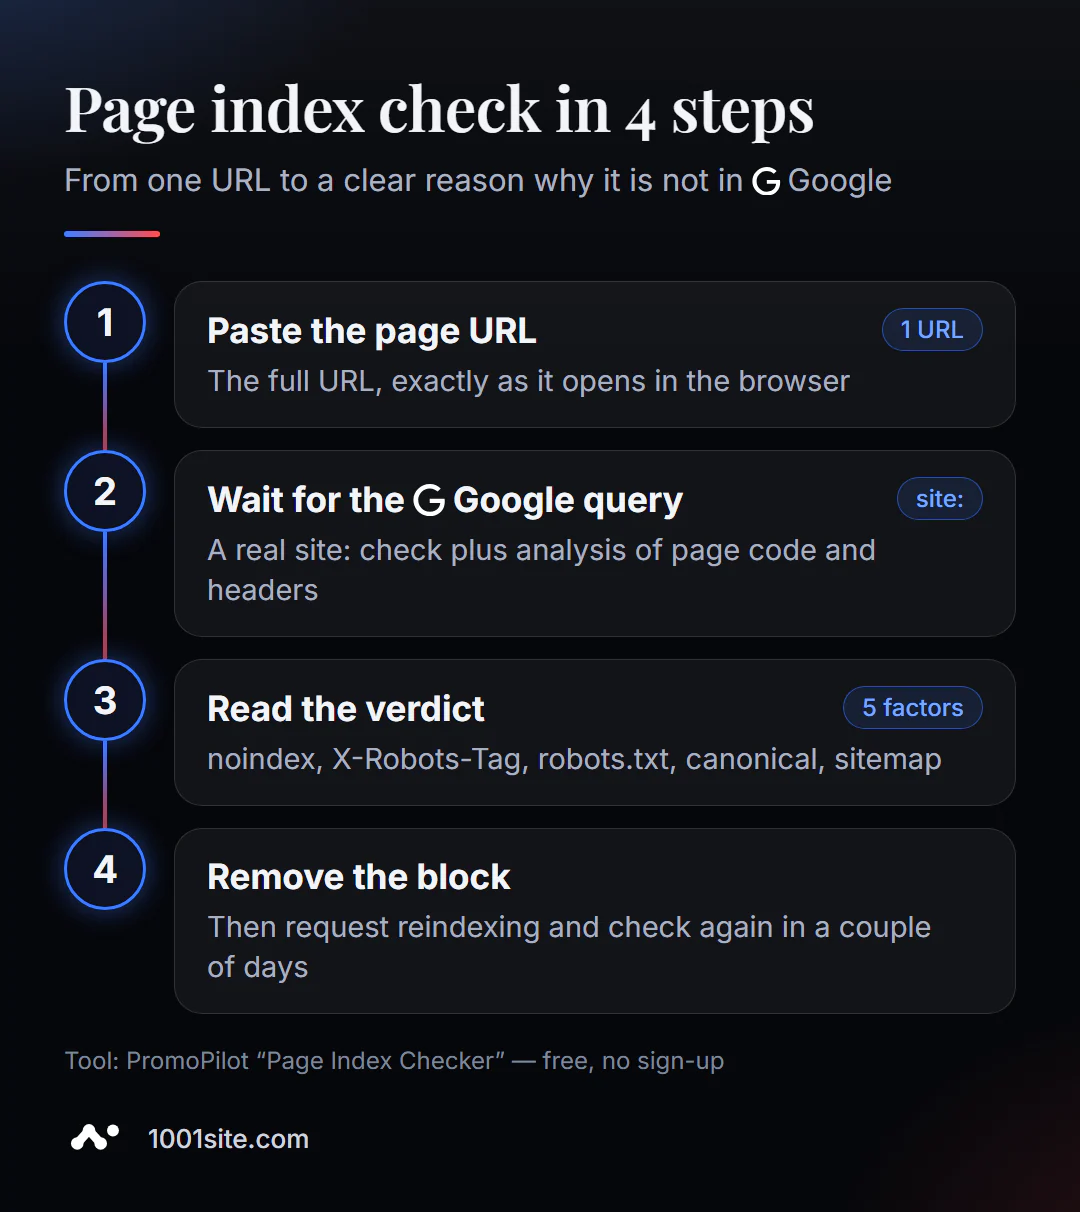
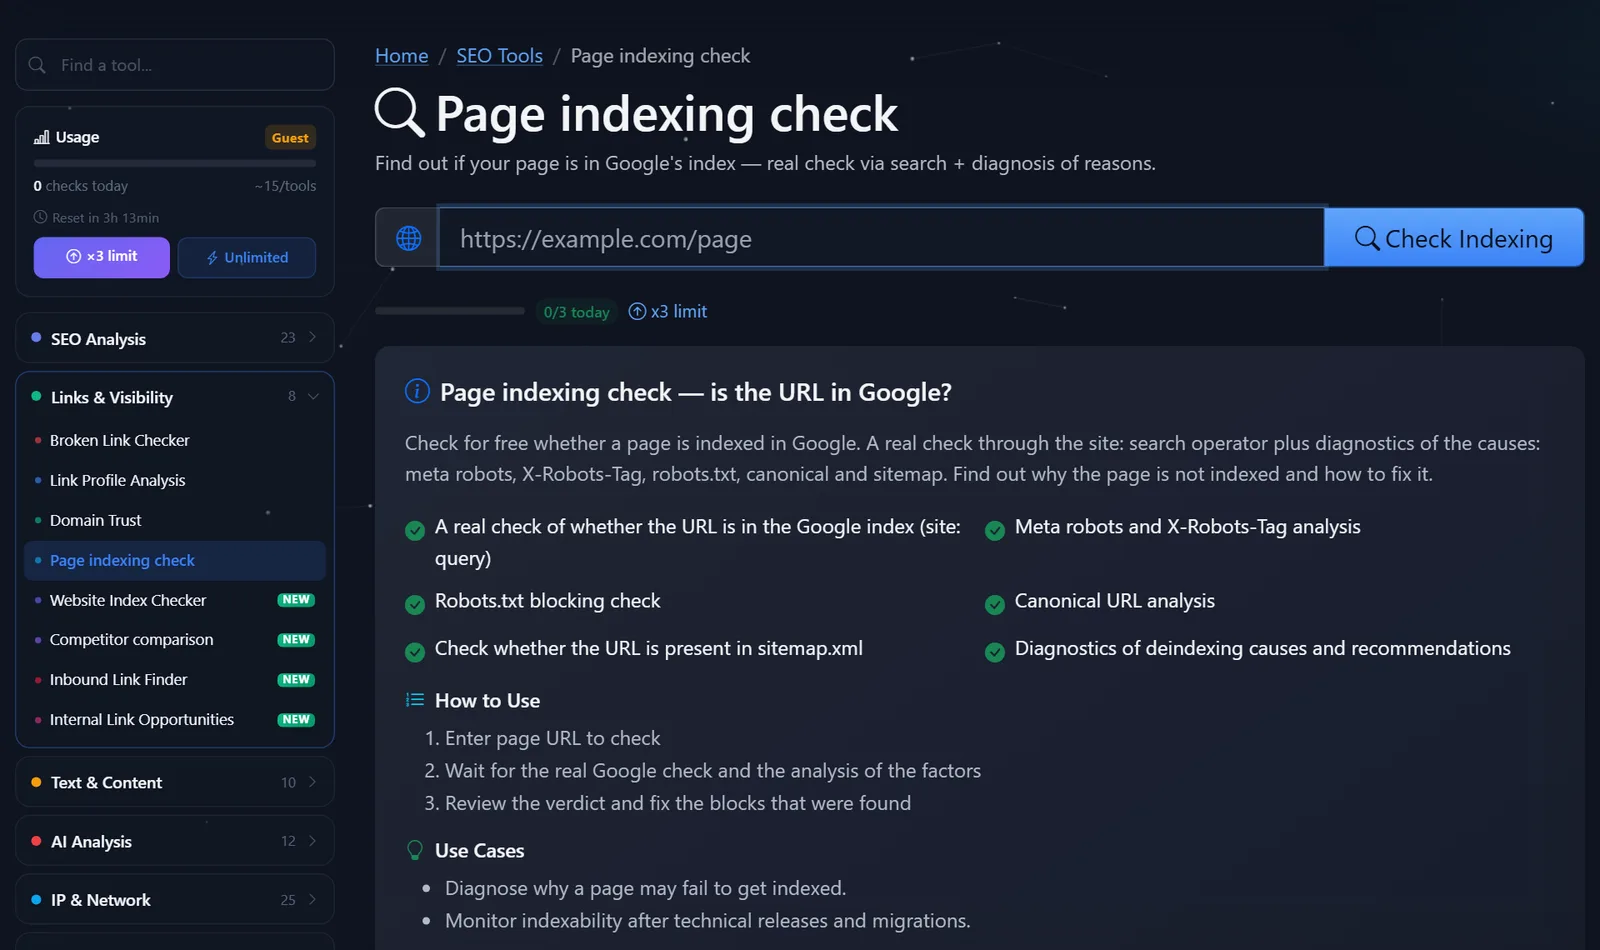
- Open pagina-indexeringscontrole.
- Plak het volledige paginaadres, inclusief het protocol en precies zoals het in de browser wordt weergegeven:
https://example.com/new-page. - Klik op "Indexering controleren" en wacht tot Google de factoren heeft opgevraagd en geanalyseerd.
- Lees het oordeel: "in index" of "niet in index" en de lijst met gevonden blokken.
- Verwijder de oorzaak en controleer het na een paar dagen opnieuw.
Zo ziet de toolpagina eruit: een adresveld, een teller voor het aantal gratis cheques van vandaag en een lijst van wat er wordt geanalyseerd.
Voorbeeld van een oordeel: De pagina https://example.com/new-page wordt geblokkeerd voor indexering omdat de code een meta noindex-tag bevat en de canonieke URL naar een andere URL verwijst. Twee redenen tegelijk, en beide bevinden zich in de template.
Waarom wordt de pagina niet geïndexeerd en wat moet ik als eerste aanpassen?
Overweeg de redenen in deze volgorde: van directe verboden tot 'zachtere' verboden.
- Noindex in meta robots of X-Robots-Tag. Verwijder dit. Een veelvoorkomende situatie: tijdens de ontwikkeling is de optie "site verbergen voor zoekmachines" in het CMS ingeschakeld en vervolgens vergeten uit te schakelen. Controleer voor de X-Robots-Tag je serverinstellingen, CDN of SEO-plugin.
- Een regel zoals
Disallow: /blog/sluit de hele sectie af. Een subtiliteit: als een pagina is afgesloten in robots.txt, kan Google de "noindex"-regel niet lezen. Om de pagina uit de index te verwijderen, moet je dus een open robots.txt-bestand met "noindex" hebben. Om de pagina weer te indexeren, hoef je alleen de "Disallow"-tag te verwijderen. - De canonical-tag verwijst naar een ander adres. Als de pagina uniek is, moet de canonical-tag naar de pagina zelf verwijzen. De fout zit vaak in de template: alle producten hebben een canonical-tag naar de categorie, alle artikelen naar de homepage van de blog.
- De pagina staat niet in de sitemap en heeft geen links. Het is een weespagina die Google niet kent. Voeg de pagina toe aan je sitemap.xml en voeg links toe vanuit pagina's die al geïndexeerd zijn, zoals menu's, categorieën en gerelateerde artikelen.
- Alles is open, maar de pagina zelf is er niet. Dit betekent dat Google de pagina wel heeft gezien, maar heeft besloten deze niet op te nemen – meestal vanwege te weinig inhoud of dubbele content. Alleen het verbeteren van de pagina zelf kan helpen.
Zo vind je zelf snel een blokkering. Open de pagina, druk op Ctrl+U en zoek naar noindex en canonical in de code. De X-Robots-Tag-header is zichtbaar in de ontwikkelaarstools van de browser (tabblad Netwerk → Documentreactie → Headers). Open robots.txt op ваш-домен/robots.txt en zoek de 'Disallow'-regels die overeenkomen met het begin van het adres van de pagina. De tool doet dit allemaal voor je, maar weten waar je moet zoeken is handig: het maakt het makkelijker om te controleren of de wijziging daadwerkelijk is doorgevoerd.
Een speciaal geval zijn pagina's met parameters en filters: ?sort=price, ?color=red, UTM-tags. Deze hoeven meestal niet te worden geïndexeerd; het is het beste als de canonical link naar de hoofdversie verwijst. Als je zo'n URL controleert en "niet geïndexeerd" ziet staan met een canonical link naar de categorie, werkt alles zoals bedoeld.
Zodra de technische problemen zijn opgelost, kunt u het proces versnellen: dien de URL van uw geverifieerde site in voor herindexering via de URL-inspectietool in Search Console. Dit is echter een verzoek, geen garantie: het kan enkele dagen tot enkele weken duren voordat nieuwe pagina's zijn geïndexeerd.
Vergelijking: Controle van de pagina-indexering van PromoPilot en alternatieven
| Hulpmiddel | Wat is gratis? | Beperkingen | Voor wie is het geschikt? |
|---|---|---|---|
| PromoPilot — Pagina-indexeringscontrole | Indexeringsfeit + Diagnostiek: noindex, X-Robots-Tag, robots.txt, canonical, sitemap | Openbare signalen, dagelijkse controlelimiet | Elke pagina, inclusief die van iemand anders, zonder toegang tot Search Console. |
| Zoekconsole - URL-controle | Exacte indexeringsstatus, herindexeringsverzoek | Alleen voor uw geverifieerde website. | Voor website-eigenaren - de belangrijkste bron van waarheid |
| Handmatige site: zoekopdracht in Google | Een snelle blik op de resultaten | Zonder de oorzaken vast te stellen, kan de uitslag onnauwkeurig zijn. | De allereerste schatting |
| Schreeuwende Kikker SEO-spider | Indexeerbaarheid van de pagina tijdens het crawlen | Toont verboden, maar niet de aanwezigheid Google; installatie vereist. | Massale controle op siteblokkering |
Conclusie: Search Console is de maatstaf voor uw website, maar u moet er wel toegang toe hebben. Online controleren is handig wanneer toegang niet beschikbaar is (bijvoorbeeld op de website van een klant, een oud project of de pagina van een concurrent) of wanneer u snel wilt vaststellen of er een technisch probleem is.
PromoPilot heeft nog 87 gratis SEO-tools. Als je vragen hebt over je hele website, en niet slechts één pagina – hoeveel pagina's het domein in Google rankt en in welk percentage van de sitemap het rankt – is er een aparte site-indexeringscontrole die in het volgende artikel in deze sectie wordt behandeld. De robots.txt-analysetool helpt je de regels in robots.txt te begrijpen.
Beperkingen van de pagina-indexeringscontrole?
De tool maakt gebruik van openbare signalen en vervangt de gegevens van de URL-inspectietool in Search Console niet: alleen de site-eigenaar kan de exacte status en redenen voor de uitsluiting Google zien.
Tijdelijke botblokkeringen – zoals DDoS-bescherming, CAPTCHA en rate limiting – kunnen de nauwkeurigheid beïnvloeden: als de tool een pagina niet kan openen, zijn de meta-robots en canonical resultaten onvolledig. Bovendien kan een recente pagina al geïndexeerd zijn, maar wordt deze niet direct weergegeven door een site: query. Als de conclusie "niet geïndexeerd" is en er geen blokkeringen zijn, controleer het dan over een paar dagen opnieuw.
Tot slot controleert de tool de pagina van buitenaf en weet niet hoe Google de kwaliteit ervan heeft beoordeeld. De status 'Gecrawld, maar nog niet geïndexeerd' is alleen zichtbaar in Search Console en wordt niet door de code, maar door de inhoud van de pagina bepaald.
Wanneer is een gratis tool niet genoeg?
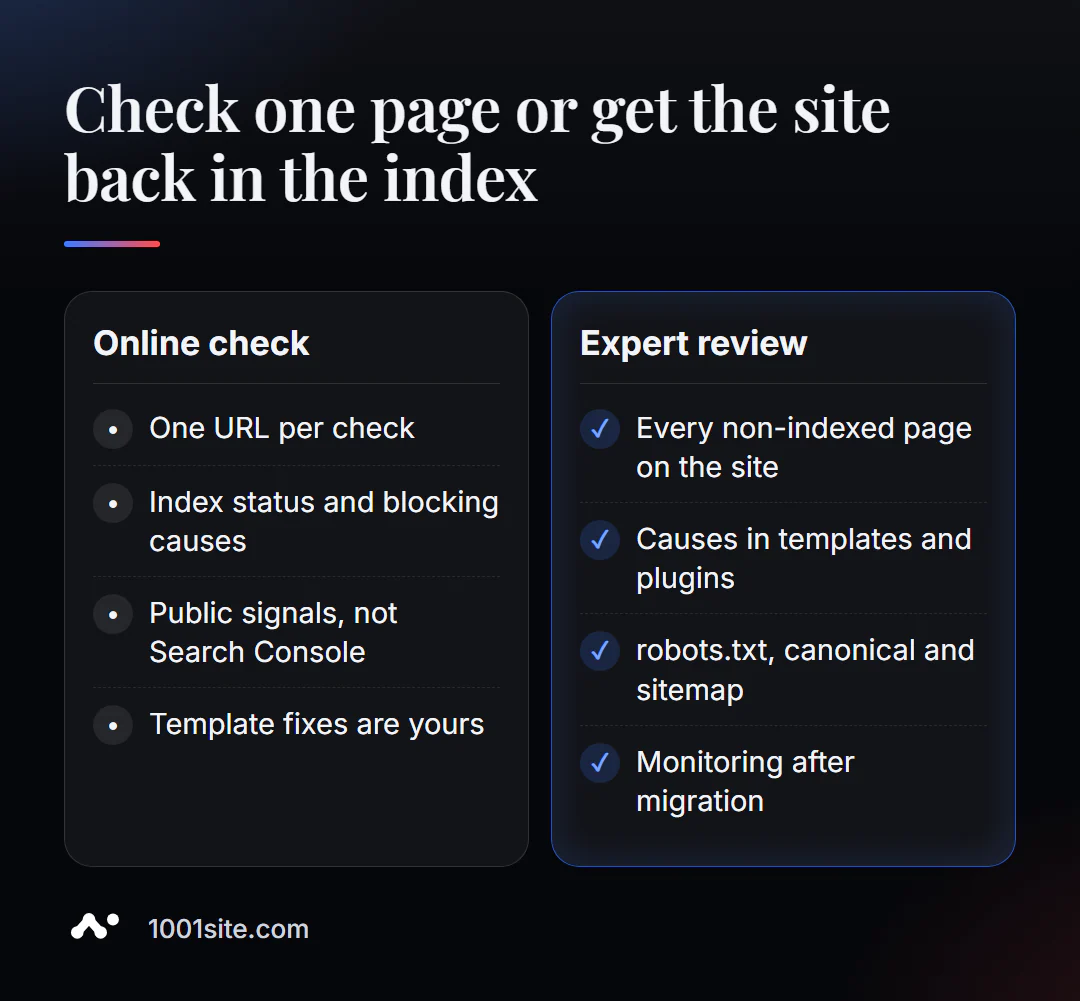
Een pagina met een vergeten noindex-tag kost vijf minuten werk. Maar het kan ingewikkelder zijn. Je hebt een specialist nodig als:
- Tientallen pagina's zijn niet geïndexeerd en er zijn geen duidelijke verboden;
- Canonical-, noindex- of robots.txt-bestanden worden gegenereerd door een plugin of sjabloon en worden na bewerking "teruggegeven";
- Na de verhuizing zijn de pagina's uit de index verwijderd en er verschijnen geen nieuwe pagina's meer;
- pagina's in de index, maar Google kiest een ander adres als het canonieke adres.
Wat kan ik voor uw website doen?
Mijn naam is Valeriy Danyuk. Ik ben een ontwikkelaar en SEO-specialist met 12 jaar ervaring en meer dan 200 klanten. Indexeringsproblemen zijn een van de meest voorkomende redenen waarom mensen contact met mij opnemen.
SEO en promotie
- Kant-en-klare SEO-audit: ik achterhaal waarom pagina's niet worden geïndexeerd en corrigeer templates, robots.txt, canonical tags en sitemaps.
- Direct geïndexeerde content: een autoblog, aangedreven door AI-agenten, publiceert artikelen met de juiste opmaak en sitemaps.
- Het indexeren van taalversies - een analyse van hoe een meertalige website te creëren zonder vertaler.
Websites en webwinkels
- Een landingspagina voor een nieuw product dat vannacht is gelanceerd en vanaf de eerste minuut indexeerbaar is.
- Krijg binnen enkele minuten een website in de stijl van je favoriete website bij 1001site: serverrendering, sitemap en markup worden automatisch geconfigureerd.
- Een winkel van Instagram naar een website overzetten – met behulp van via Google gevonden kaarten.
CRM, boekhouding en automatisering
Stuur me via Telegram het adres van een pagina die niet in Google staat vermeld - dan vertel ik je waar je de oorzaak kunt vinden.
Resultaat
- Door de indexeringsstatus van een pagina te controleren, worden twee vragen beantwoord: of de URL in Google staat en wat verhindert dat deze daar terechtkomt.
- Redenen per frequentie: noindex (in code of header), robots.txt, canonical link naar een ander adres, weespagina zonder sitemap en links.
- Nadat je het probleem hebt opgelost, dien je de URL in bij Search Console voor herindexering en controleer je het na een paar dagen opnieuw.
- Als tientallen pagina's niet geïndexeerd zijn, is een audit nodig, en een oude site met complexe sjablonen is soms gemakkelijker opnieuw op te bouwen op 1001site.
Controleer de pagina die uit de zoekresultaten is verdwenen; binnen een minuut verschijnt een verklaring met de reden.
Bronnen
- De pagina van de tool "Pagina-indexeringscontrole" van PromoPilot: lijst met controles, voorbeeld en beperkingen.
- Help Google Search Console - Hulpmiddel voor URL-inspectie.
- Google Search Central - Blokkeer indexering met noindex.
- Google Search Central - Canonieke URL's en dubbele pagina's.