Короткий ответ: чтобы проверить robots.txt онлайн, введите домен в Анализ robots.txt PromoPilot и нажмите «Анализировать». Инструмент сам загрузит файл, разберёт все директивы (Allow, Disallow, Crawl-delay, Sitemap), покажет блоки User-agent и роботов, на которых они нацелены, найдёт синтаксические ошибки и рискованные правила, проверит доступность критичных URL и даст рекомендации. Бесплатно, без регистрации.
Самая дорогая строка, которую я встречал в чужом robots.txt, — Disallow: /, оставшаяся после разработки. Сайт запустили, рекламу оплатили, а органика три недели стояла на нуле, потому что роботам запретили заходить на все страницы.
Что проверяет анализ robots.txt?
Robots.txt — короткий текстовый файл в корне сайта, но ошибиться в нём легко: одна лишняя косая черта меняет смысл правила. Инструмент читает файл так, как его читают поисковые роботы.
| Что смотрит инструмент | Пример | Зачем это для SEO |
|---|---|---|
| Все директивы | Allow, Disallow, Crawl-delay, Sitemap |
Видно, что именно разрешено и запрещено |
| Блоки User-agent | User-agent: *, User-agent: Googlebot |
Правила для конкретного робота перекрывают общие |
| Ссылки на Sitemap | Sitemap: https://example.com/sitemap.xml |
Робот быстрее находит карту сайта |
| Синтаксические ошибки | Dissalow, правило без блока User-agent |
Неверная строка просто игнорируется |
| Рискованные правила | Disallow: /, закрытые /catalog/, CSS и JS |
Важные страницы выпадают из сканирования |
| Доступность критичных URL | Главная, основные разделы | Подтверждение, что ключевые страницы открыты |
Пример результата из описания инструмента: «найдено 2 потенциально рискованных правила Disallow и 1 отсутствующая директива Sitemap». Именно такие находки и стоят внимания в первую очередь.
Как проверить robots.txt онлайн?
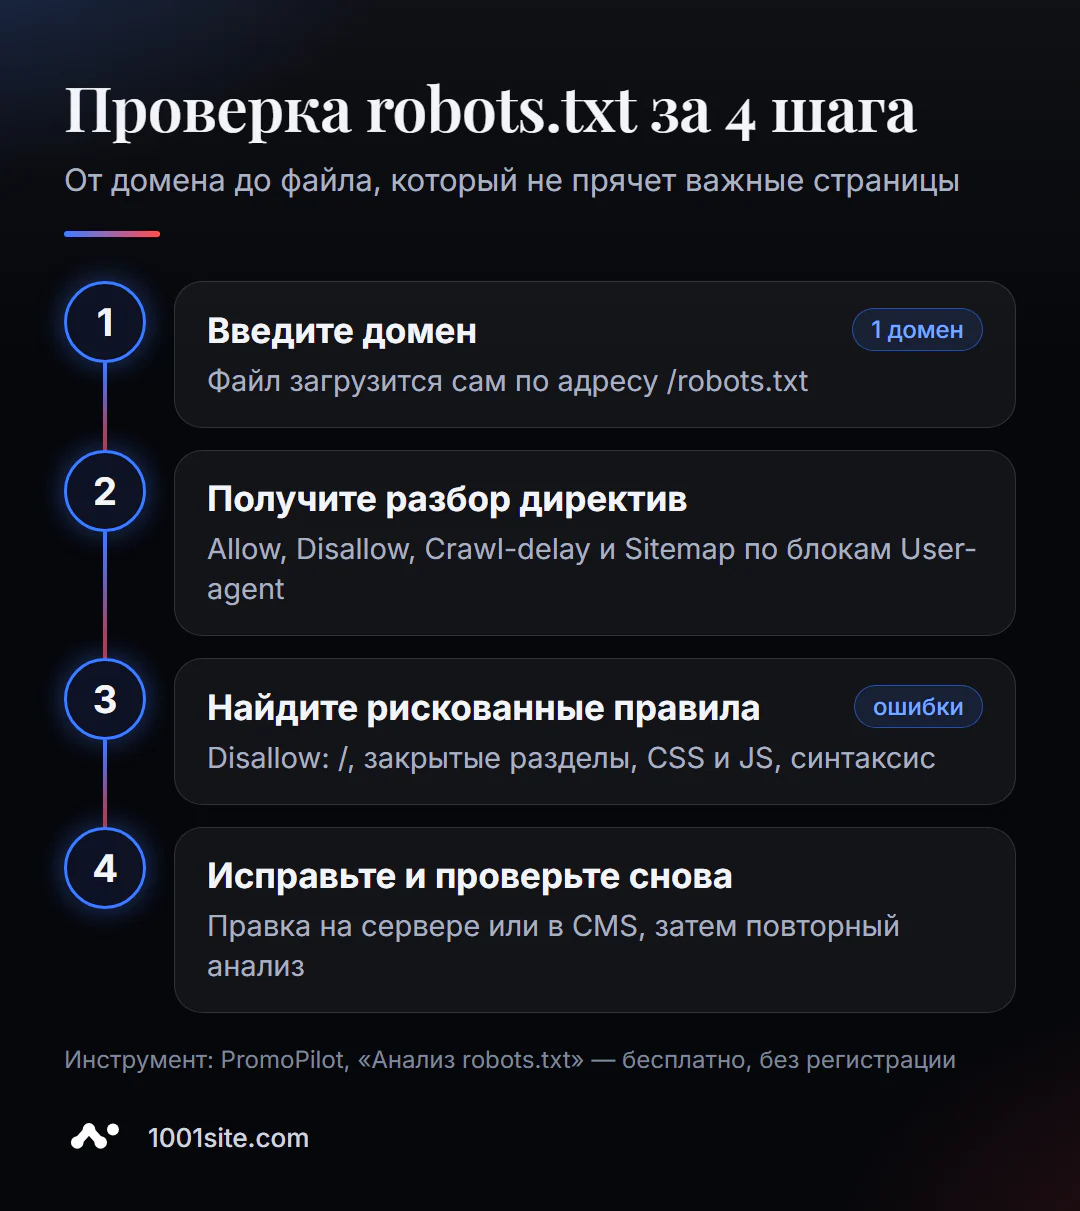
- Откройте инструмент. Анализ robots.txt работает в браузере.
- Введите домен —
https://example.com. Файл загрузится автоматически по адресу/robots.txt. - Нажмите «Анализировать».
- Изучите список директив по блокам User-agent.
- Разберите ошибки и рискованные правила — это главное в отчёте.
- Исправьте файл на сервере или в настройках CMS и запустите проверку повторно.
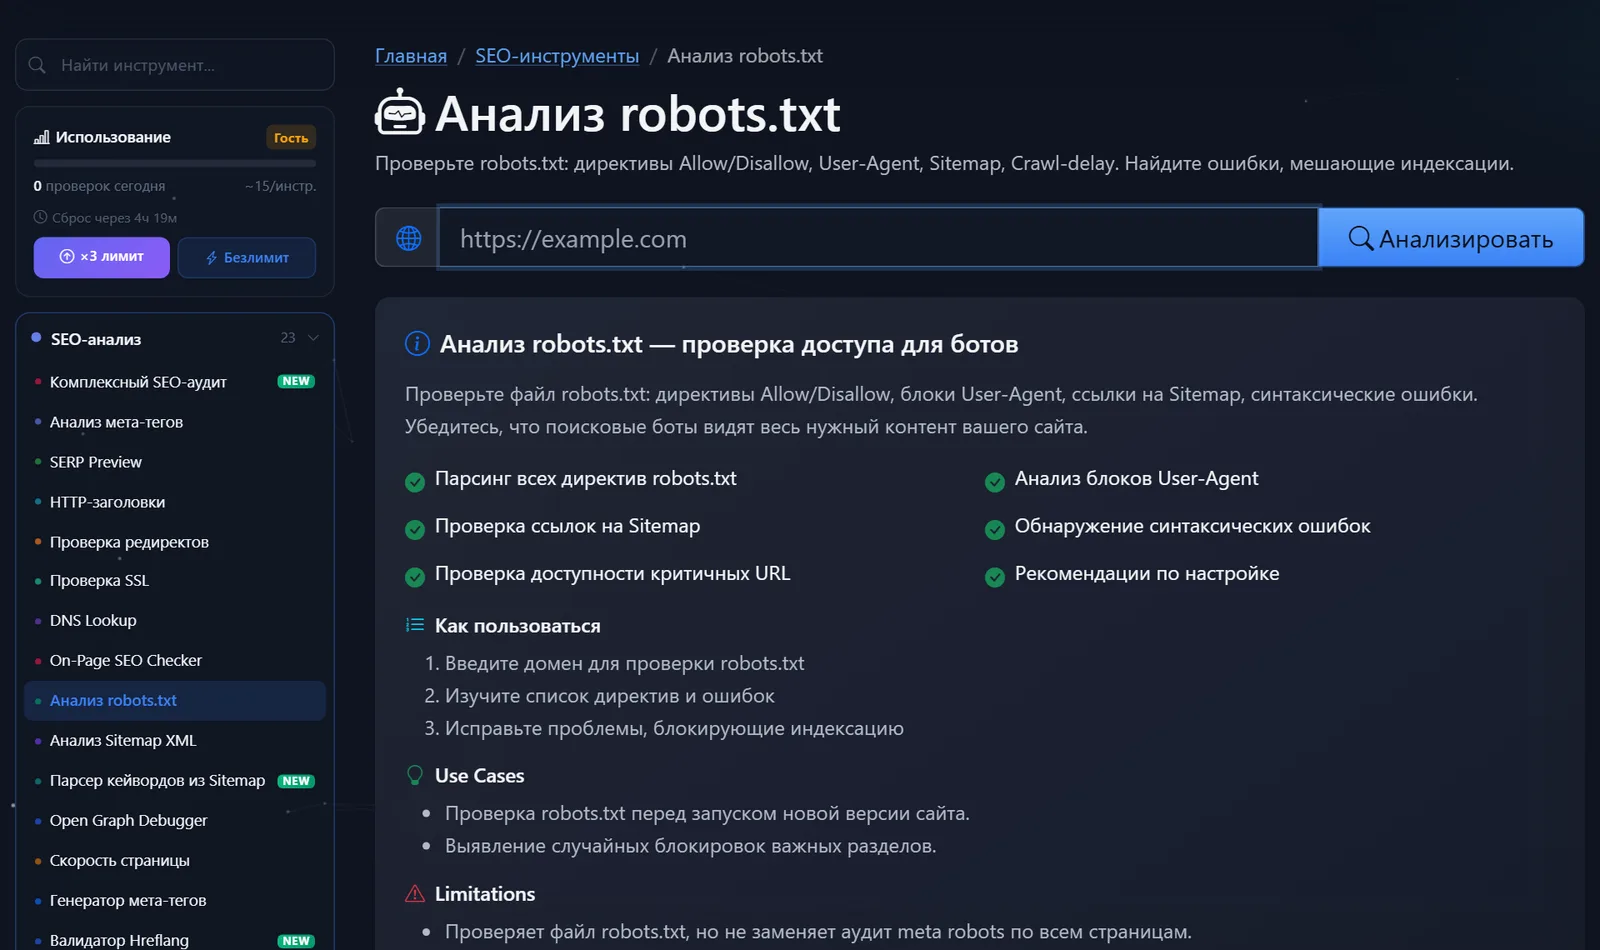
Страница инструмента: поле для адреса, кнопка «Анализировать» и описание — что проверяется, сценарии и ограничения.
Проверяйте robots.txt в двух обязательных случаях: перед запуском новой версии сайта и после любого переезда. Именно тогда тестовые запреты чаще всего «уезжают» в рабочую версию. Полезно проверить и файл конкурента: по закрытым разделам видно, какие страницы он считает служебными и как устроен его каталог.
Как читать результат и что исправить первым?
Двигайтесь от правил, которые закрывают весь сайт, к косметике.
Disallow: /в блокеUser-agent: *. Закрыт весь сайт. Если это не тестовая версия — удаляйте строку немедленно.- Закрыты важные разделы.
Disallow: /catalogзакрывает не только каталог, но и всё, что начинается с этих символов, например/catalog-sale/. Правила работают по началу пути, и регистр букв важен. - Закрыты CSS, JS и картинки. Правило вроде
Disallow: /wp-content/мешает Google увидеть страницу так, как её видит человек. Робот должен загружать стили и скрипты. - Нет строки Sitemap или она ведёт на 404. Укажите полный адрес карты сайта с протоколом.
- Синтаксис. Опечатки в названиях директив, правила вне блока User-agent, пустые строки внутри блока — неверные строки роботы игнорируют, и правило молча не работает.
- Директивы, которые Google не поддерживает.
Crawl-delayGooglebot игнорирует, аNoindexв robots.txt Google не поддерживает. Если вы на них рассчитываете — правило не действует.
Пример правильного файла для сайта на WordPress:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /?s=
Disallow: /cart/
Disallow: /checkout/

Sitemap: https://example.com/sitemap.xml
Закрыты админка, внутренний поиск и служебные страницы магазина, открыт AJAX-обработчик, без которого ломаются части сайта, и указана карта сайта. Всё остальное по умолчанию разрешено.
Как понять, открыт ли конкретный адрес, если правил много? Google применяет самое конкретное правило — то, у которого путь длиннее. Если в файле есть Disallow: /blog/ и Allow: /blog/seo/, то страница /blog/seo/proverka/ открыта, а /blog/news/ закрыта. При равной длине побеждает разрешающее правило. Звёздочка * заменяет любую последовательность символов, а $ обозначает конец адреса: Disallow: /*.pdf$ закрывает все PDF-файлы, но не страницу /pdf-guide/.
Ещё одна частая находка — несколько блоков для одного и того же робота или общий блок, который «перекрывается» отдельным. Если в файле есть User-agent: Googlebot, то Googlebot читает только этот блок и полностью игнорирует правила из User-agent: *. Поэтому все нужные запреты придётся продублировать в его блоке.
Отдельная тема 2026 года — ИИ-краулеры. Блок User-agent: GPTBot с Disallow: / запрещает OpenAI обходить сайт. Это ваше решение, но учтите: если сайт закрыт для ИИ-ботов, ассистентам сложнее его рекомендовать.
Сравнение: анализ robots.txt в PromoPilot и альтернативы
| Инструмент | Что бесплатно | Ограничения | Кому подходит |
|---|---|---|---|
| PromoPilot — Анализ robots.txt | Разбор директив и блоков, ошибки, рискованные правила, рекомендации | Только robots.txt, без метатегов страниц | Быстро проверить свой или чужой сайт |
| Google Search Console — отчёт robots.txt | Как Google получил ваш файл, когда и с какими ошибками | Только для своего подтверждённого сайта | Владельцам сайтов |
| Screaming Frog SEO Spider | Обход сайта с учётом robots.txt, проверка своих правил | Программу нужно установить | Техническому аудиту |
| Ручная проверка в браузере | Открыть /robots.txt и прочитать |
Без разбора ошибок и подсказок | Если файл из трёх строк |
Вывод: Search Console показывает, как файл видит Google, но только для вашего сайта. Онлайн-анализ работает с любым доменом и объясняет, что не так.
Анализ robots.txt — один из 87 бесплатных SEO-инструментов PromoPilot. Если файла нет вовсе или его проще переписать с нуля, загляните в соседнюю статью раздела о генераторе robots.txt — там собираем файл в визуальном конструкторе. А для проверки самой карты сайта есть отдельный анализ sitemap.xml.
Ограничения: что проверка robots.txt не заменит?
Инструмент проверяет только файл robots.txt и не заменяет аудит метатегов robots на уровне страниц. Страница может быть открыта в robots.txt, но закрыта метатегом noindex или заголовком X-Robots-Tag — такие запреты ищите проверкой страницы или полным аудитом.
Разные роботы по-разному трактуют нестандартные директивы. То, что поддерживает один поисковик, другой молча пропустит. Опирайтесь на стандартные User-agent, Allow, Disallow и Sitemap — их понимают все крупные поисковые системы.
И помните: robots.txt — не защита. Он вежливо просит роботов не заходить, но не закрывает доступ. Админку и личные данные защищают паролем, а не строчкой Disallow. Более того, robots.txt открыт всем: перечисляя в нём «секретные» разделы, вы сами показываете их любопытным.
Когда бесплатного инструмента мало?
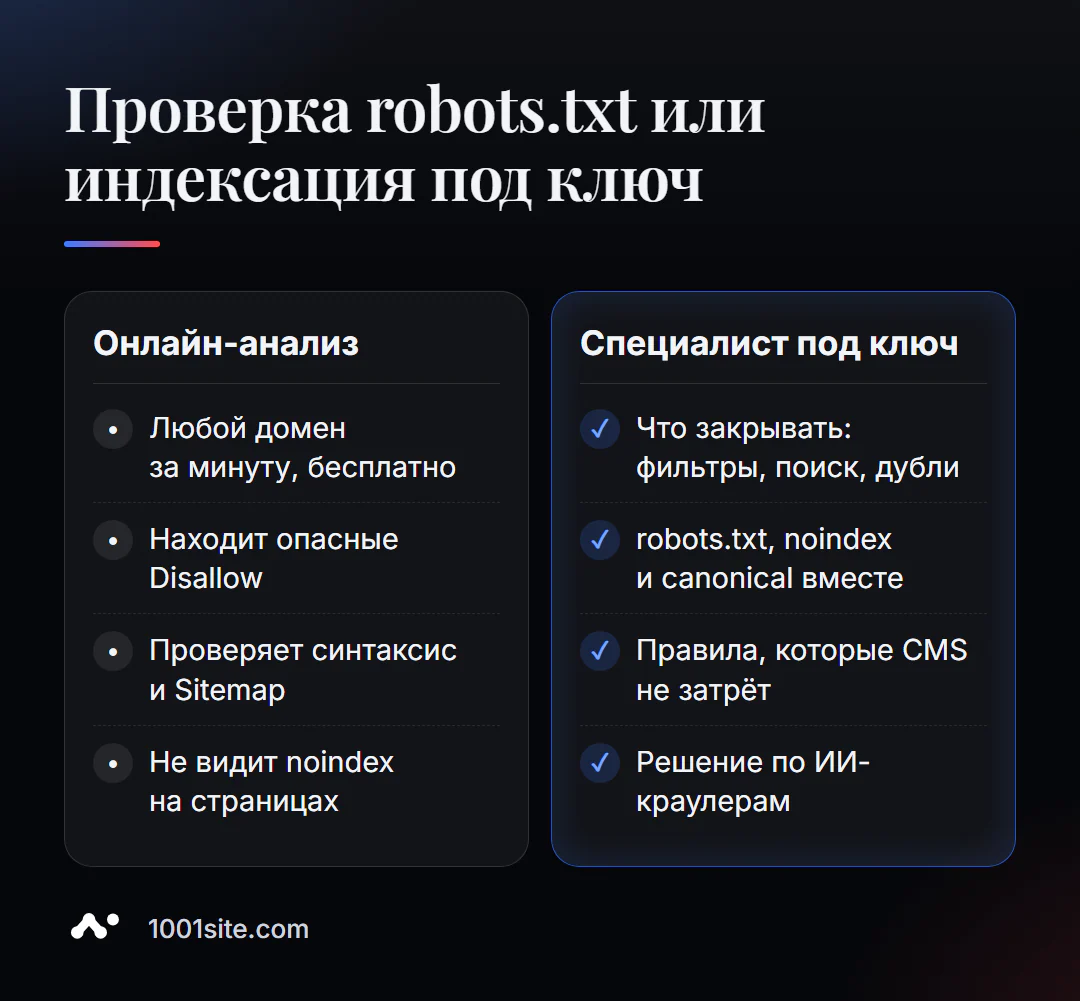
Найти рискованное правило — полдела. Решить, какие разделы закрывать, — уже стратегия. Специалист нужен, если:
- у магазина тысячи страниц фильтров и сортировок, и непонятно, что из них закрывать;
- сайт выпал из поиска, а robots.txt «вроде бы в порядке»;
- robots.txt генерирует CMS или плагин, и ваши правки перезаписываются;
- нужно решить, пускать ли ИИ-краулеры, и как это скажется на видимости в ассистентах.
Что я могу сделать для вашего сайта?
Меня зовут Валерий Данюк, я разработчик и SEO-специалист: 12 лет, 200+ клиентов. Robots.txt, метатеги и карта сайта — первое, что я проверяю в каждом аудите.
SEO и продвижение
- SEO-аудит под ключ: robots.txt, noindex, canonical, sitemap и реальная индексация — с исправлениями.
- Автоблог с ИИ-агентами — редакция без людей, которая публикует статьи и сразу открывает их для индексации.
- GEO: как отель попал в рекомендации ChatGPT, Gemini и Perplexity — кейс о видимости в ответах ИИ-ассистентов.
Сайты и интернет-магазины
- Сайт на WordPress с ИИ-помощником за 299 € — с правильным robots.txt и картой сайта с первого дня.
- Сайт на 1001site: sitemap, структурированные данные и индексация ИИ-ботами настроены автоматически.
CRM, учёт и автоматизация
- ERP, сайт и Telegram-бот с ИИ для авторазборки за 6 дней.
- Дропшиппинг-платформа с магазинами партнёров — где каждому магазину нужен свой корректный robots.txt.
Все кейсы — в портфолио. Пришлите адрес в Telegram — прочитаю ваш robots.txt и скажу, не закрыто ли лишнее.
Итог
- Проверка robots.txt онлайн за минуту находит правила, которые прячут сайт или его разделы от роботов.
- Чините по порядку:
Disallow: /→ закрытые разделы → CSS и JS → Sitemap → синтаксис. - Disallow не убирает страницу из индекса — для этого нужен
noindexна открытой странице. - Если robots.txt генерирует CMS, а правки не держатся, проще доверить настройку специалисту или перейти на 1001site, где индексация настроена из коробки.
Проверьте свой файл прямо сейчас: запустите бесплатный анализ robots.txt, а если найдутся рискованные правила — напишите мне в Telegram.
Источники
- Страница инструмента «Анализ robots.txt» PromoPilot — проверки, пример результата и вопросы страницы.
- Google Search Central — введение в robots.txt и поддерживаемые директивы.
- Справка Google Search Console — отчёт о файле robots.txt.