مختصر جواب: ایک robots.txt فائل آن لائن بنانے کے لیے، PromoPilot robots.txt جنریٹر کو کھولیں، ایک پیش سیٹ منتخب کریں (اپنی مرضی کے مطابق، تمام کی اجازت دیں، سب سے انکار کریں، WordPress ، Laravel، یا Next.js)، Disallow اور Allow کے لیے راستے درج کریں، Sitemap لائن کے لیے ویب سائٹ کا پتہ درج کریں، اور اختیاری طور پر Crawl AI کو بلاک کریں۔ مکمل فائل دائیں طرف ظاہر ہوگی — آپ اسے کاپی یا ڈاؤن لوڈ کرسکتے ہیں۔ یہ مفت ہے اور کسی رجسٹریشن کی ضرورت نہیں ہے۔
میں ہر نئی ویب سائٹ کے لیے robots.txt لکھتا ہوں اور جانتا ہوں کہ دستی طور پر غلطیاں کرنا کتنا آسان ہے: ایک اضافی جگہ، بھولا ہوا سلیش، بلاک کے باہر ایک اصول۔ robots.txt بلڈر اس مسئلے کو ختم کرتا ہے — آپ سوچتے ہیں کہ کیا بند کرنا ہے، نحو نہیں۔ ذیل میں، ہم وضاحت کریں گے کہ اسے کیسے استعمال کرنا ہے، کیا بند کرنا ہے، اور تیار فائل کو کہاں رکھنا ہے۔
robots.txt جنریٹر کیا کرتا ہے؟
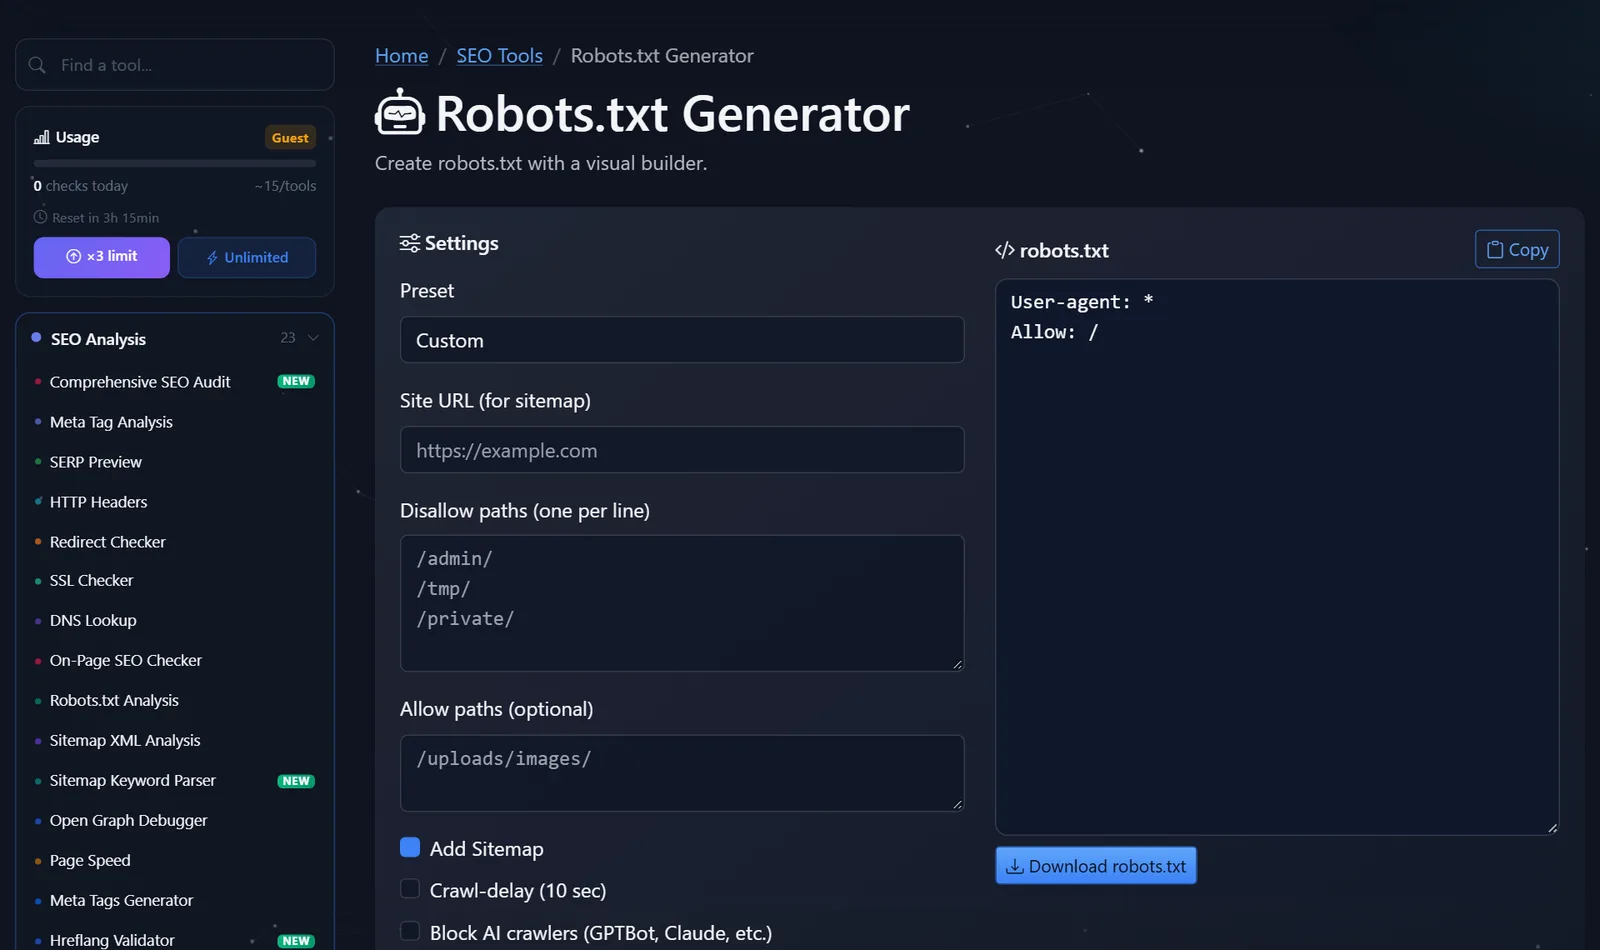
جنریٹر ٹیکسٹ ایڈیٹر کے بجائے ایک شکل ہے۔ آپ ترتیبات کو منتخب کرتے ہیں، اور ٹول انہیں ایک درست فائل میں جمع کرتا ہے اور اسے لائیو پیش نظارہ میں دکھاتا ہے۔
| ترتیب دے رہا ہے۔ | کیا سیٹ کرتا ہے | سائٹ کو اس کی ضرورت کیوں ہے؟ |
|---|---|---|
| پیش سیٹ | اپنی مرضی کے مطابق، سب کی اجازت دیں، سب سے انکار کریں، WordPress ، لاراول، Next.js | آپ کے انجن کے لیے ایک ریڈی میڈ سٹارٹنگ پوائنٹ |
| ویب سائٹ کا URL | Sitemap لائن کا پتہ | روبوٹ خود سائٹ کا نقشہ تلاش کرتے ہیں۔ |
| راستوں کی اجازت نہ دیں۔ | سکین نہ کیے جانے والے حصے، فی لائن ایک | روبوٹ ایڈمن پینل اور سروس پیجز پر وقت ضائع نہیں کرتا۔ |
| راستوں کی اجازت دیں۔ | بند حصوں میں مستثنیات | مطلوبہ فائل کو بند فولڈر میں کھولیں۔ |
| کرال میں تاخیر (10 سیکنڈ) | روبوٹ کی درخواستوں کے درمیان وقفہ کریں۔ | روبوٹ کے لیے کمزور سرور پر بوجھ کو کم کرنا جو اسے مدنظر رکھتے ہیں۔ |
| AI کرالر کو مسدود کرنا | GPTBot، Claude ، اور دیگر AI بوٹس پر پابندی | کنٹرول کریں کہ آپ کا مواد کون استعمال کرتا ہے۔ |
| پیش نظارہ، کاپی، ڈاؤن لوڈ | تیار شدہ robots.txt فائل | آپ اسے فوری طور پر سرور پر اپ لوڈ کر سکتے ہیں۔ |
حد کو سمجھنا ضروری ہے: جنریٹر ایک فائل بناتا ہے، لیکن یہ موجودہ فائل کو چیک نہیں کرتا ہے۔ اگر آپ کے پاس پہلے سے ہی ایک robots.txt فائل ہے اور آپ اس میں غلطیاں تلاش کرنا چاہتے ہیں، تو آپ کو robots.txt فائل کا تجزیہ کرنے کی ضرورت ہے—اگلے حصے میں مضمون اسی کے لیے وقف ہے۔
robots.txt آن لائن کیسے بنائیں؟
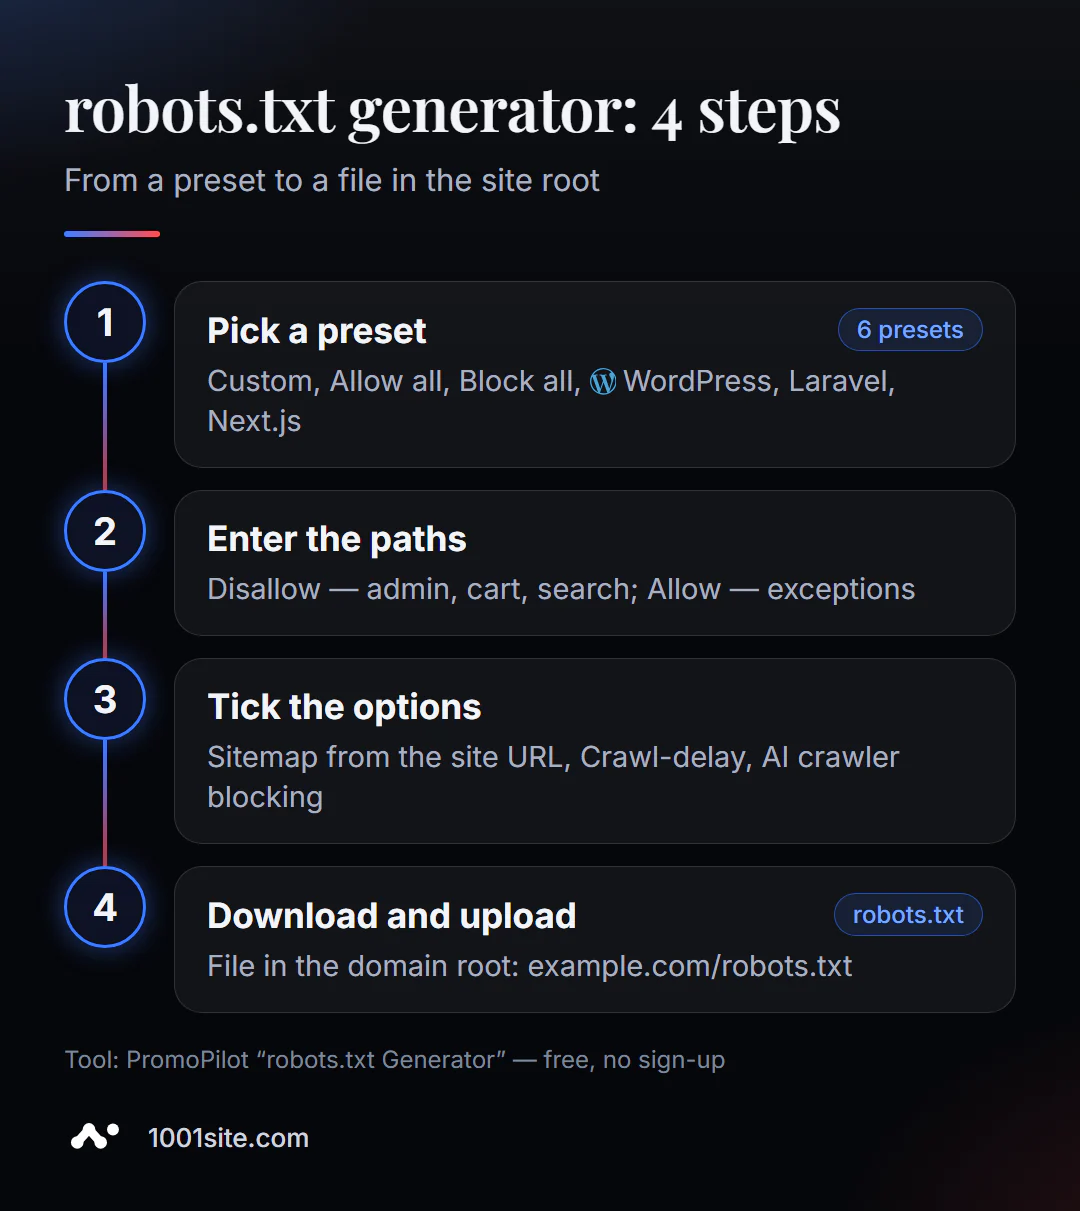
- robots.txt جنریٹر کھولیں۔
- اپنے انجن کے لیے ایک پیش سیٹ منتخب کریں ۔ اگر آپ کا انجن درج نہیں ہے تو "اپنی مرضی کے مطابق" کو منتخب کریں۔
- ویب سائٹ کا پتہ درج کریں —
https://example.com۔ یہ ایکSitemapلائن بنائے گا۔ - Disallow paths شامل کریں ، ایک فی لائن:
/admin/,/tmp/,/search/۔ - اگر ضروری ہو تو، محدود فولڈرز کے اندر استثناء کی اجازت شامل کریں ، جیسے
/uploads/images/۔ - خانوں کو چیک کریں: سائٹ کا نقشہ، کرال-دیری، بلاک اے آئی کرالرز۔
- فائل کو کاپی یا ڈاؤن لوڈ کریں اور اسے سائٹ کے روٹ پر اپ لوڈ کریں۔
صفحہ کے بائیں جانب ترتیبات ہیں، اور دائیں جانب "کاپی" اور "ڈاؤن لوڈ robots.txt" بٹنوں کے ساتھ فائل کا لائیو پیش نظارہ ہے۔
فائل کو ڈومین کی جڑ میں سختی سے واقع ہونا چاہیے: https://example.com/robots.txt ۔ روبوٹ اسے /blog/robots.txt فولڈر میں یا کسی اور ذیلی ڈومین پر نہیں ڈھونڈیں گے—ہر ذیلی ڈومین کی اپنی robots.txt فائل ہوتی ہے۔
ڈاؤن لوڈ کی گئی فائل کو کہاں اپ لوڈ کرنا ہے اس کا انحصار پلیٹ فارم پر ہے:
- باقاعدہ ہوسٹنگ - پینل کے فائل مینیجر یا FTP کے ذریعے اس فولڈر میں جہاں مرکزی صفحہ واقع ہے (اکثر
public_htmlیاwww)۔ - WordPress — اگر کوئی فزیکل فائل نہیں ہے تو انجن ایک ورچوئل robots.txt فائل پیش کرتا ہے۔ فائل کو روٹ پر اپ لوڈ کرنا اس کی جگہ لے لیتا ہے۔ دوسرا آپشن SEO پلگ ان میں فائل ایڈیٹر کا استعمال کرنا ہے۔
- Next.js اور دیگر فریم ورک — فائل کو
publicفولڈر میں رکھا جاتا ہے یا پروجیکٹ کوڈ سے تیار کیا جاتا ہے تاکہ اگلی تعیناتی کے دوران یہ ضائع نہ ہو۔ - ویب سائٹ بنانے والے - فائل کو عام طور پر دستی طور پر اپ لوڈ کرنے کے بجائے SEO کی ترتیبات میں ترمیم کیا جاتا ہے۔
فائل کا نام robots.txt چھوٹے حروف میں ہونا چاہیے اور UTF-8 انکوڈنگ میں سادہ متن کے طور پر محفوظ کرنا چاہیے۔ ڈاؤن لوڈ کرنے کے بعد، اسے اپنے براؤزر میں کھولیں: اگر آپ کو اپنا متن نظر آتا ہے، تو سب کچھ اپنی جگہ پر ہے۔
robots.txt میں کیا بند ہونا چاہیے اور کیا نہیں؟
بنیادی اصول: کسی بھی ایسی چیز کو بند کریں جو تلاش میں قدر میں اضافہ نہ کرے اور روبوٹ کا وقت ضائع کرے۔ کسی بھی چیز کو بند نہ کریں جو روبوٹ کے لیے صفحہ کو سمجھنے کے لیے ضروری ہو۔
عام طور پر بند:
- ایڈمن پینل اور ذاتی اکاؤنٹ:
/admin/,/wp-admin/,/account/; - ٹوکری اور چیک آؤٹ:
/cart/,/checkout/; - اندرونی تلاش:
/search/,/?s=; - سروس اور عارضی فولڈرز:
/tmp/,/cgi-bin/; - فلٹرز اور چھانٹنے کے اختیارات کے لامتناہی مجموعے - صاف، صرف اس صورت میں جب مطلوبہ فلٹرز کے لیے علیحدہ لینڈنگ پیجز ہوں۔
کبھی بند نہ کریں:
- CSS، JavaScript، اور تصاویر—ان کے بغیر، Google صفحہ کو اس طرح نہیں دیکھے گا جس طرح انسان دیکھے گا۔
- کیٹلاگ، بلاگ، پروڈکٹ کارڈز اور لینڈنگ پیجز؛
- وہ صفحات جنہیں آپ انڈیکس سے ہٹانا چاہتے ہیں - اس کے لیے آپ کو
noindexضرورت ہے، اور روبوٹ کو اسے پڑھنے کے قابل ہونا چاہیے۔
یہاں وہ فائل ہے جو آپ کو WooCommerce کے ساتھ ایک عام WordPress اسٹور کے لیے ملے گی:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /cart/
Disallow: /checkout/
Disallow: /my-account/
Disallow: /?s=

Sitemap: https://example.com/sitemap.xml
جھنڈوں کے حوالے سے۔ Google کرال میں تاخیر کو مدنظر نہیں رکھتا ہے — اسے صرف اس صورت میں فعال کریں جب آپ کا سرور دوسرے بوٹس سے متاثر ہو۔ AI کرالر کو مسدود کرنا ایک کاروباری فیصلہ ہے: اگر آپ چاہتے ہیں کہ ChatGPT ، Gemini ، اور Perplexity آپ کے بارے میں جانیں اور آپ کو تجویز کریں، تو ان کی رسائی کو مسدود نہ کریں۔
ایک اور عملی نقطہ سائٹ کا ٹیسٹ ورژن ہے۔ اسٹیجنگ کاپی کے لیے، "Deny All" کا پیش سیٹ استعمال کریں، لیکن لانچ کے وقت فائل کو تبدیل کرنا یقینی بنائیں: a forgotten Disallow: / وہ چیز ہے جو اکثر نئی سائٹس پر ٹریفک کو کم کرتی ہے۔
موازنہ: پرومو پائلٹ جنریٹر اور Robots.txt بنانے کے دوسرے طریقے
| راستہ | کیا مفت ہے؟ | پابندیاں | یہ کس کے لیے موزوں ہے؟ |
|---|---|---|---|
| PromoPilot — Robots.txt جنریٹر | پیش سیٹ، اجازت نہ دیں اور اجازت دیں، سائٹ کا نقشہ، کرال-تاخیر، AI بوٹ بلاکنگ، ڈاؤن لوڈ | آپ کو فائل کو خود سرور پر اپ لوڈ کرنے کی ضرورت ہے۔ | مبتدیوں اور کسی ایسے شخص کے لیے جو نحو کو یاد نہیں رکھنا چاہتے |
| WordPress SEO پلگ ان میں ایڈیٹر (جیسے Yoast SEO) | ایڈمن پینل سے براہ راست فائل میں ترمیم کرنا | صرف WordPress کے لیے، آپ نحو خود لکھتے ہیں۔ | WordPress ویب سائٹ کے مالکان کے لیے |
| Next.js میں روبوٹ فائل | robots.txt پروجیکٹ کوڈ سے تیار کیا گیا ہے۔ | ڈویلپر کی ضرورت ہے۔ | Next.js پروجیکٹس |
| ٹیکسٹ ایڈیٹر | مکمل آزادی | غلطیاں کرنا آسان ہے، کوئی سراغ نہیں۔ | ان لوگوں کے لیے جو معیار کو دل سے جانتے ہیں۔ |
نتیجہ: جنریٹر نحو کو جانے بغیر درست فائل حاصل کرنے کا تیز ترین طریقہ ہے۔ جب ویب سائٹ کے ساتھ فائل کو تبدیل کرنے کی ضرورت ہو تو پلگ ان اور پروجیکٹ کوڈ آسان ہوتے ہیں۔
جنریٹر PromoPilot کے 87 مفت SEO ٹولز میں سے ایک ہے۔ فائل کو ڈاؤن لوڈ کرنے کے بعد، اسے robots.txt تجزیہ کار سے چیک کریں، اور سائٹ کا نقشہ لائن کے لیے، sitemap.xml جنریٹر کا استعمال کریں—دونوں کا احاطہ اس سیکشن کے ملحقہ مضامین میں کیا گیا ہے۔
جنریٹر کی حدود: یہ آپ کے لیے کیا نہیں کرے گا۔
جنریٹر کو آپ کی سائٹ کی ساخت کا علم نہیں ہے۔ WordPress پیش سیٹ عام سروس کے راستوں کو بند کردے گا، لیکن یہ اندازہ نہیں لگائے گا کہ آپ کے اسٹور کے فلٹرز /filter/ اور اندرونی تلاش /find/ میں رہتے ہیں۔ آپ کو خود ان راستوں میں داخل ہونا پڑے گا۔
یہ فائل کو سرور پر اپ لوڈ نہیں کرتا یا یہ چیک نہیں کرتا کہ فائل 200 اسٹیٹس کوڈ کے ساتھ /robots.txt پر قابل رسائی ہے۔ اپ لوڈ کرنے کے بعد، براؤزر میں ایڈریس کھولیں یا اسے پارسر کے ذریعے چلائیں۔
اور یہ noindex جگہ نہیں لیتا ہے: اگر مقصد تلاش کے نتائج سے صفحات کو ہٹانا ہے تو robots.txt مناسب نہیں ہے۔ آخر میں، فائل آپ کے ڈیٹا کی حفاظت نہیں کرتی ہے: یہ عوامی ہے، اور کوئی بھی پڑھ سکتا ہے کہ آپ نے کن سیکشنز کو لاک کیا ہے۔ پاس ورڈ کے پیچھے راز پوشیدہ ہوتے ہیں۔
ایک مفت ٹول کب کافی نہیں ہے؟
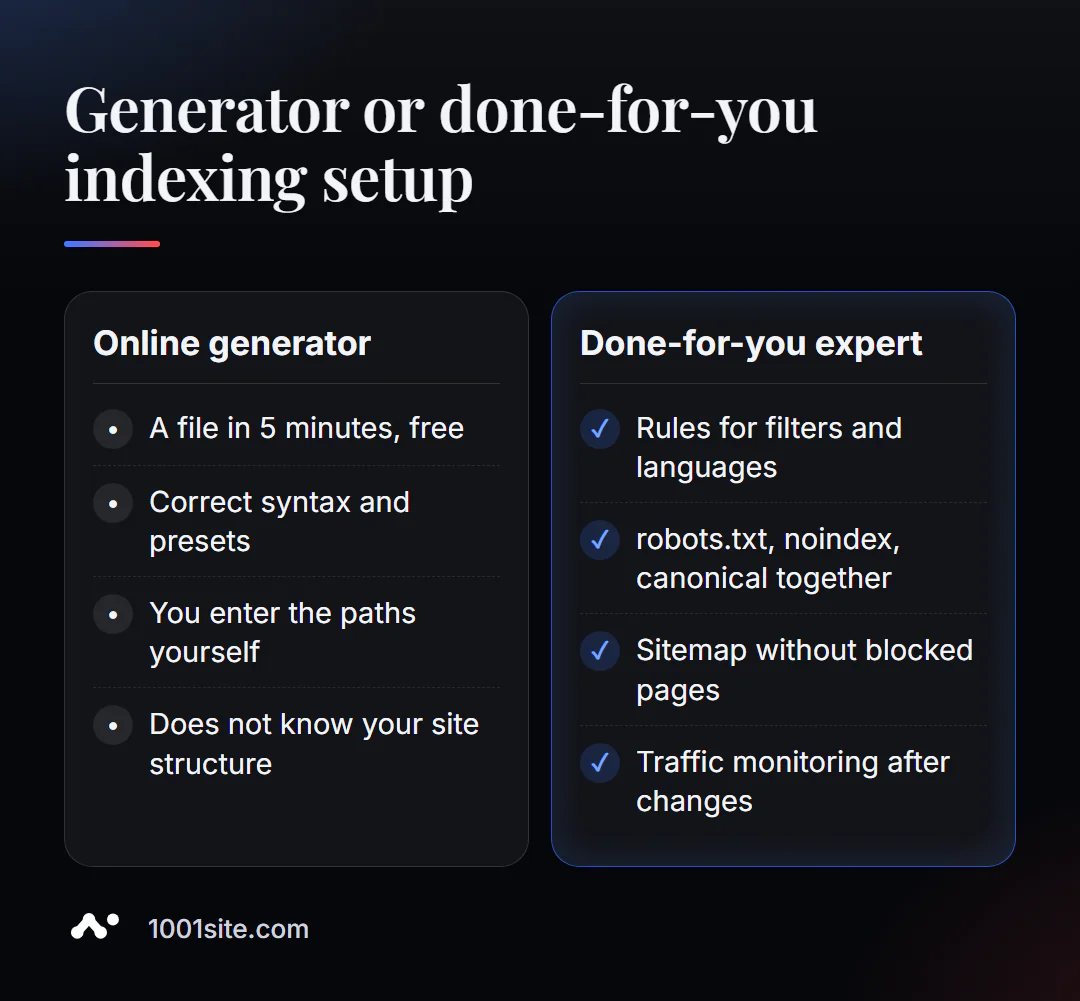
فائل بنانے میں پانچ منٹ لگتے ہیں۔ ہزاروں صفحات والی سائٹ پر کیا لاک کرنا ہے یہ فیصلہ کرنا بہت کام ہے۔ آپ کو ایک ماہر کی ضرورت ہے اگر:
- اسٹور میں سیکڑوں فلٹر امتزاج ہیں، اور ان میں سے کچھ ٹریفک پیدا کرتے ہیں۔
- سائٹ کثیر لسانی ہے، ذیلی ڈومینز پر یا زبانوں کے لیے الگ فولڈرز کے ساتھ؛
- robots.txt میں ترمیم کرنے کے بعد، ٹریفک میں کمی آئی، اور یہ واضح نہیں ہے کہ کون سا اصول قصوروار ہے؛
- آپ کو ایک سسٹم میں robots.txt، میٹا ٹیگز، کینونیکل اور سائٹ کا نقشہ سیدھ میں کرنے کی ضرورت ہے۔
میں آپ کی ویب سائٹ کے لیے کیا کر سکتا ہوں؟
میرا نام Valeriy Danyuk ہے، میں 12 سال کا تجربہ اور 200 سے زیادہ کلائنٹس کے ساتھ ایک ڈویلپر اور SEO ماہر ہوں۔ ایک مناسب robots.txt فائل میری بنائی ہوئی ہر ویب سائٹ کا حصہ ہے۔
SEO اور فروغ
- ٹرنکی SEO آڈٹ: robots.txt، noindex، canonical، اور sitemap ایک متحد نظام کے طور پر، نہ کہ بے ترتیب اصولوں کا مجموعہ۔
- ایک AI سے چلنے والا SEO بلاگ جو نامیاتی لیڈز لاتا ہے ۔
- مترجم کے بغیر ایک کثیر لسانی ویب سائٹ — جہاں robots.txt اور سائٹ کا نقشہ تمام زبانوں کو مدنظر رکھنا چاہیے۔
ویب سائٹس اور آن لائن اسٹورز
- WooCommerce آن لائن اسٹور: 40+ ٹیمپلیٹس، €299 — کارٹ، فلٹرز اور چیک آؤٹ کے لیے robots.txt کے ساتھ۔
- 1001site پر ایک ویب سائٹ، جہاں سائٹ کا نقشہ اور اشاریہ سازی خود بخود ترتیب دی جاتی ہے۔ یہ سبسکرپشن فیس والے بلڈر سے کیسے مختلف ہے؟ ٹلڈا بمقابلہ AI سے چلنے والی ویب سائٹ کا تجزیہ۔
CRM، اکاؤنٹنگ اور آٹومیشن
- آن لائن اسٹور کے لیے ماہانہ اکاؤنٹنگ سسٹم – جمہوریہ چیک کی کمپنی کے لیے ایک پروجیکٹ۔
- QuestFlow AI کے ساتھ Telegram SaaS بلڈر ہے ۔
پورٹ فولیو میں مزید۔ یقین نہیں ہے کہ کیا احاطہ کرنا ہے؟ مجھے Telegram میں اپنی ویب سائٹ کا پتہ بھیجیں – میں آپ کے ڈھانچے کے لیے اصول تجویز کروں گا۔
نتیجہ
- آن لائن robots.txt جنریٹر پانچ منٹ میں ایک درست فائل بناتا ہے: پیش سیٹ، راستے، سائٹ کا نقشہ، جھنڈے۔
- ایڈمن پینل، ری سائیکل بن، تلاش اور سروس فولڈرز کو بند کریں۔ CSS، JS، کیٹلاگ، یا بلاگ کو بند نہ کریں۔
- robots.txt انڈیکس سے صفحات کو نہیں ہٹاتا ہے -
noindexکے لیے یہی ہے۔ - ایک پیچیدہ ڈھانچہ، فلٹرز اور زبانیں سیٹ اپ کو کسی ماہر کے سپرد کرنے یا 1001site پر ایک سائٹ بنانے کی وجہ ہیں، جہاں اشاریہ سازی کو باکس سے باہر ترتیب دیا گیا ہے۔
مفت robots.txt جنریٹر کا استعمال کرتے ہوئے ابھی اپنی خود کی robots.txt فائل بنائیں، اور اگر آپ کو قواعد کے بارے میں کوئی سوال ہے، تو مجھے Telegram پر لکھیں ۔
ذرائع
- PromoPilot کا robots.txt جنریٹر ٹول صفحہ — سیٹنگز، پیش سیٹس، اور صفحہ کے سوالات۔
- Google سرچ سینٹرل - Robots.txt فائل کیسے بنائیں اور جمع کرائیں۔
- Next.js دستاویزات - روبوٹ میٹا ڈیٹا فائل۔