Kort svar: för att skapa en robots.txt-fil online, öppna PromoPilot robots.txt-generatorn, välj en förinställning (Anpassad, Tillåt alla, Neka alla, WordPress, Laravel eller Next.js), ange sökvägarna för Disallow och Tillåt, ange webbplatsadressen för webbplatskartan och markera eventuellt Crawl-delay eller blockera AI-crawlers. Den färdiga filen visas till höger – du kan kopiera den eller ladda ner den. Det är gratis och kräver ingen registrering.
Jag skriver robots.txt för varje ny webbplats och vet hur lätt det är att göra misstag manuellt: ett extra mellanslag, ett glömt snedstreck, en regel utanför ett block. Robots.txt-byggaren eliminerar detta problem – du tänker på vad som ska stängas, inte syntaxen. Nedan förklarar vi hur du använder den, vad som ska stängas och var du ska placera den färdiga filen.
Vad gör robots.txt-generatorn?
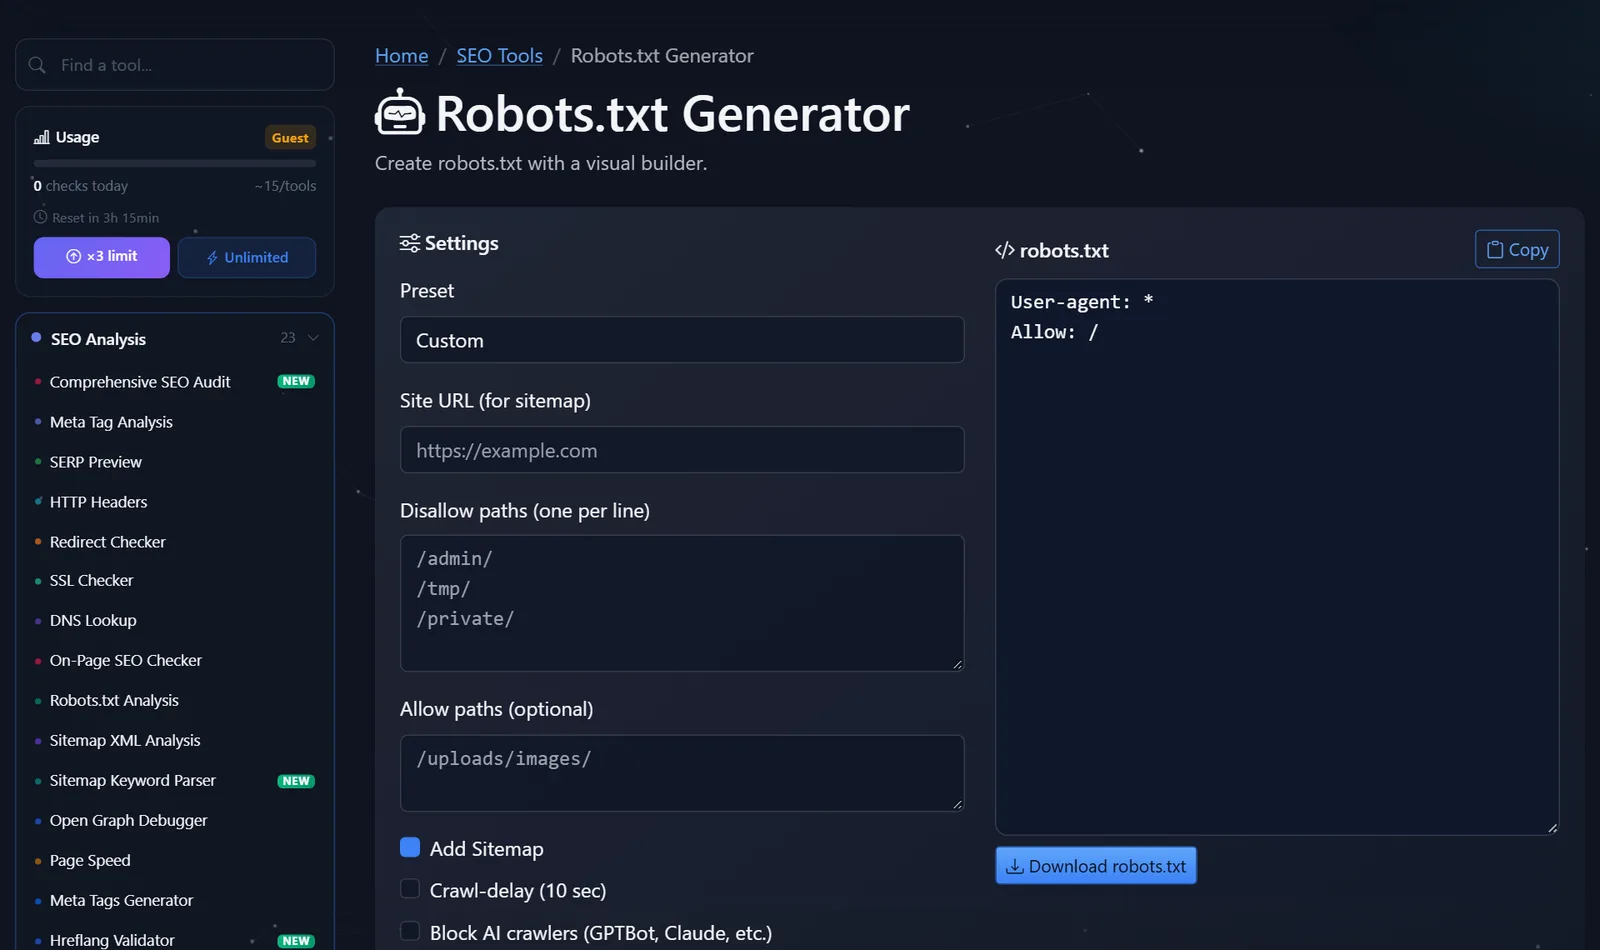
Generatorn är ett formulär istället för en textredigerare. Du väljer inställningarna, och verktyget samlar dem i en giltig fil och visar den i en liveförhandsvisning.
| Konfigurera | Vilka uppsättningar | Varför behöver webbplatsen detta? |
|---|---|---|
| Förinställa | Anpassad, Tillåt alla, Neka alla, WordPress, Laravel, Next.js | En färdig startpunkt för din motor |
| Webbplatsens URL | Adress för Sitemap rad | Robotar hittar webbplatskartan själva |
| Tillåt inte sökvägar | Avsnitt som inte ska skannas, ett per rad | Roboten slösar inte tid på administratörspanelen och servicesidorna. |
| Tillåt sökvägar | Undantag inom stängda sektioner | Öppna önskad fil i en stängd mapp |
| Krypningsfördröjning (10 sek) | Pausa mellan robotförfrågningar | Avlasta en svag server för robotar som tar hänsyn till det |
| Blockera AI-crawlers | Avstängning för GPTBot, Claude och andra AI-botar | Kontrollera vem som använder ditt innehåll |
| Förhandsgranska, kopiera, ladda ner | Den färdiga robots.txt -filen | Du kan ladda upp den till servern direkt. |
Det är viktigt att förstå begränsningen: generatorn skapar en fil, men kontrollerar inte en befintlig. Om du redan har en robots.txt-fil och vill hitta fel i den måste du analysera robots.txt-filen – artikeln i nästa avsnitt ägnas åt detta.
Hur skapar man robots.txt online?
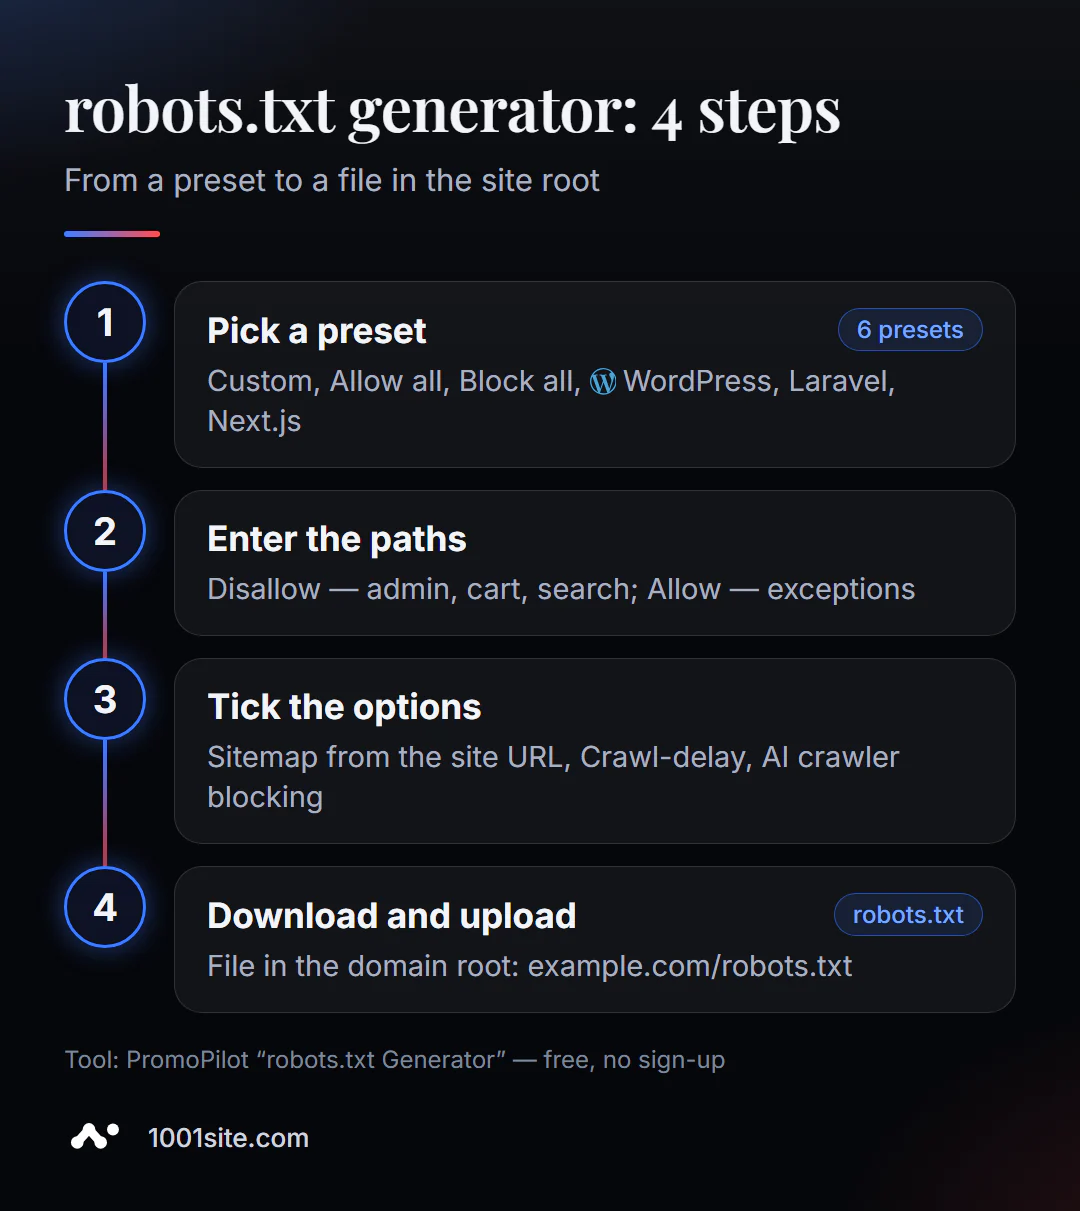
- Öppna robots.txt-generatorn.
- Välj en förinställning för din motor. Om din motor inte finns med i listan väljer du "Anpassad".
- Ange webbplatsadressen —
https://example.com. Detta skapar enSitemap. - Lägg till Disallow-sökvägar, en per rad:
/admin/,/tmp/,/search/. - Om det behövs, lägg till Tillåt undantag i begränsade mappar, till exempel
/uploads/images/. - Markera rutorna: Webbplatskarta, Genomsökningsfördröjning, blockera AI-sökrobotar.
- Kopiera eller ladda ner filen och ladda upp den till webbplatsens rot.
På vänster sida av sidan finns inställningarna, och till höger finns en liveförhandsvisning av filen med knapparna "Kopiera" och "Ladda ner robots.txt".
Filen måste finnas strikt i roten av domänen: https://example.com/robots.txt. Robotar hittar den inte i mappen /blog/robots.txt eller på en annan underdomän – varje underdomän har sin egen robots.txt-fil.
Var exakt den nedladdade filen ska laddas upp beror på plattformen:
- Vanlig hosting – via panelens filhanterare eller FTP till mappen där huvudsidan finns (ofta
public_htmlellerwww). - WordPress — om det inte finns någon fysisk fil, serverar sökmotorn en virtuell robots.txt-fil. Att ladda upp filen till roten ersätter den; det andra alternativet är att använda filredigeraren i SEO-pluginet.
- Next.js och andra ramverk — filen placeras i den
publicmappen eller genereras från projektkoden så att den inte går förlorad under nästa distribution. - Webbplatsbyggare – filen redigeras vanligtvis i SEO-inställningarna snarare än laddas upp manuellt.
Filen måste ha namnet robots.txt i gemener och sparas i UTF-8-kodning som vanlig text. Efter nedladdningen öppnar du den i din webbläsare: om du ser din text är allt på plats.
Vad bör och bör inte stängas i robots.txt?
Huvudprincipen: stäng allt som inte tillför värde till sökningen och slösar bort robotens tid. Stäng inte något som är viktigt för att roboten ska förstå sidan.
Vanligtvis stängt:
- administratörspanel och personligt konto:
/admin/,/wp-admin/,/account/; - varukorg och kassa:
/cart/,/checkout/; - intern sökning:
/search/,/?s=; - service- och temporära mappar:
/tmp/,/cgi-bin/; - Oändliga kombinationer av filter och sorteringsalternativ – snyggt, bara om det finns separata landningssidor för de nödvändiga filtren.
Stäng aldrig:
- CSS, JavaScript och bilder – utan dem kommer Google inte att se sidan på samma sätt som en människa skulle göra;
- katalog, blogg, produktkort och landningssidor;
- sidor du vill ta bort från indexet - för detta behöver du
noindex, och roboten måste kunna läsa den.
Här är filen du får för en typisk WordPress butik med WooCommerce:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /cart/
Disallow: /checkout/
Disallow: /my-account/
Disallow: /?s=

Sitemap: https://example.com/sitemap.xml
Angående flaggor. Google tar inte hänsyn till crawl-fördröjning – aktivera det bara om din server lider av andra bottar. Att blockera AI-crawlers är ett affärsbeslut: om du vill att ChatGPT, Gemini och Perplexity ska veta om dig och rekommendera dig, blockera inte deras åtkomst.
En annan praktisk punkt är testversionen av webbplatsen. För testversionen, använd förinställningen "Neka alla", men se till att ersätta filen vid start: en glömd Disallow: / är det som oftast minskar trafiken till nya webbplatser.
Jämförelse: PromoPilot Generator och andra sätt att skapa Robots.txt
| Sätt | Vad är gratis? | Begränsningar | Vem är det lämpligt för? |
|---|---|---|---|
| PromoPilot — Robots.txt-generator | Förinställningar, Tillåt och förbjud, Webbplatskarta, Fördröjning av genomsökning, Blockering av AI-botar, Nedladdning | Du måste ladda upp filen till servern själv. | För nybörjare och alla som inte vill komma ihåg syntax |
| Redigerare i ett WordPress SEO-plugin (t.ex. Yoast SEO) | Redigera en fil direkt från administratörspanelen | Endast för WordPress skriver du syntaxen själv | För WordPress -webbplatsägare |
| Robots-fil i Next.js | robots.txt genereras från projektkoden | Utvecklare behövs | Next.js -projekt |
| Textredigerare | Fullständig frihet | Lätt att göra misstag, inga ledtrådar | För dig som kan standarden utantill |
Slutsats: Generatorn är det snabbaste sättet att få en giltig fil utan att känna till syntaxen. Plugin-programmet och projektkoden är praktiska när filen behöver ändras tillsammans med webbplatsen.
Generatorn är ett av PromoPilots 87 gratis SEO-verktyg. Efter att du har laddat ner filen, kontrollera den med en robots.txt-analysator och för webbplatskartraden, använd sitemap.xml-generatorn – båda tas upp i de intilliggande artiklarna i det här avsnittet.
Generatorbegränsningar: Vad den inte kommer att göra för dig
Generatorn känner inte till din webbplats struktur. WordPress förinställning stänger de typiska sökvägarna för tjänster, men den gissar inte att din butiks filter finns i /filter/ och den interna sökningen i /find/. Du måste ange dessa sökvägar själv.
Den laddar inte upp filen till servern och kontrollerar inte att filen är tillgänglig på /robots.txt med statuskoden 200. Efter uppladdningen, öppna adressen i en webbläsare eller kör den genom en parser.
Och den ersätter inte noindex: om målet är att ta bort sidor från sökresultaten är robots.txt inte lämplig. Slutligen skyddar inte filen dina data: den är offentlig och vem som helst kan läsa vilka avsnitt du har låst. Hemligheter är dolda bakom ett lösenord.
När räcker inte ett gratisverktyg?
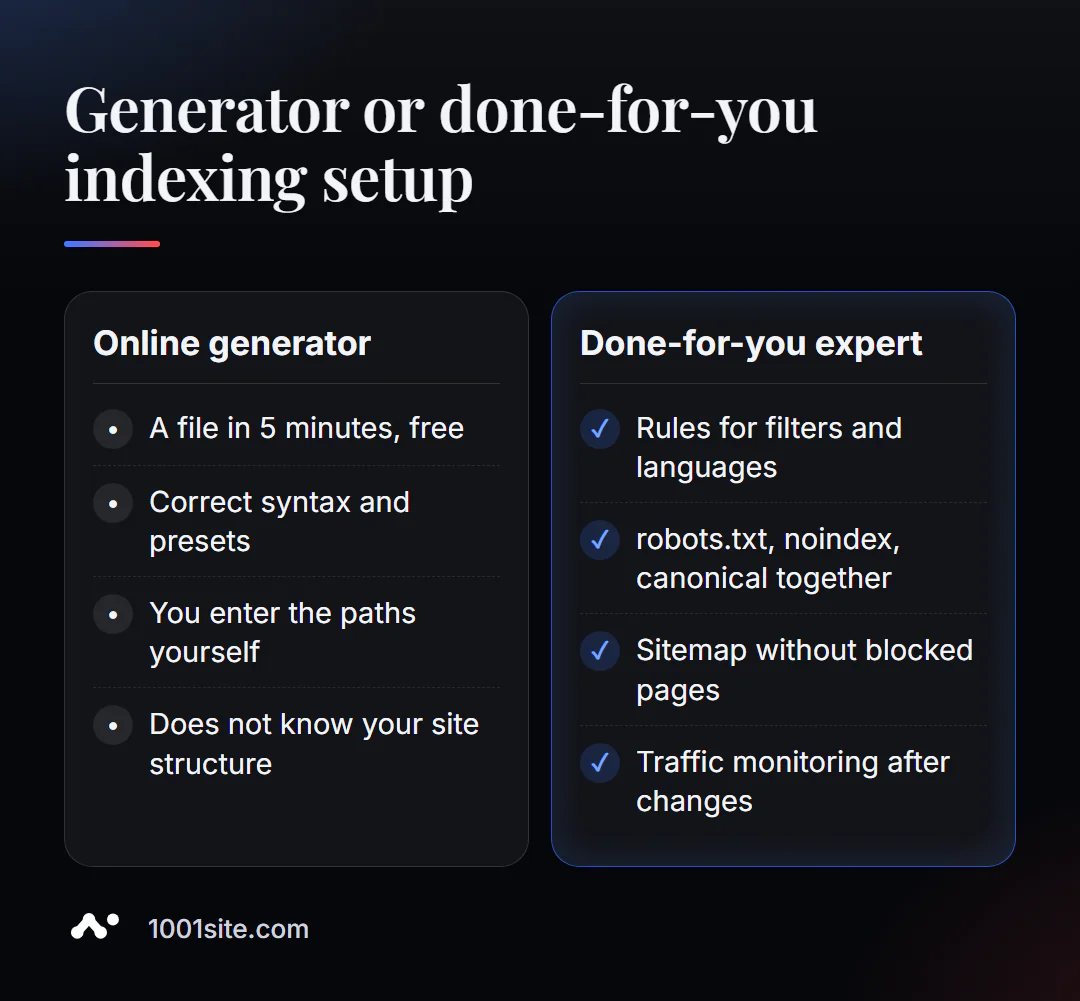
Att generera en fil tar fem minuter. Att bestämma vad som ska låsas på en webbplats med tusentals sidor är mycket arbete. Du behöver en specialist om:
- Butiken har hundratals filterkombinationer, och några av dem genererar trafik;
- webbplatsen är flerspråkig, på underdomäner eller med separata mappar för språk;
- Efter att ha redigerat robots.txt minskade trafiken, och det är oklart vilken regel som är skyldig;
- Du måste samordna robots.txt, metataggar, canonical och sitemap i ett system.
Vad kan jag göra för er webbplats?
Mitt namn är Valeriy Danyuk, jag är utvecklare och SEO-specialist med 12 års erfarenhet och över 200 kunder. En korrekt robots.txt-fil är en del av varje webbplats jag bygger.
SEO och marknadsföring
- Nyckelfärdig SEO-granskning: robots.txt, noindex, canonical och sitemap som ett enhetligt system, inte en uppsättning slumpmässiga regler.
- En AI-driven SEO-blogg som genererar organiska leads.
- En flerspråkig webbplats utan översättare — där robots.txt och webbplatskarta måste ta hänsyn till alla språk.
Webbplatser och onlinebutiker
- WooCommerce webbutik: 40+ mallar, 299 € — med robots.txt för varukorg, filter och kassa.
- En webbplats på 1001site, där webbplatskartan och indexeringen konfigureras automatiskt. Hur skiljer sig detta från en byggare med en prenumerationsavgift? Tilda vs. AI-driven webbplatsanalys.
CRM, redovisning och automatisering
- Ett månatligt redovisningssystem för en webbutik – ett projekt för ett företag från Tjeckien.
- QuestFlow är en SaaS-byggare Telegram botar med AI.
Mer i portföljen. Är du osäker på vad du ska täcka? Skicka mig din webbadress i Telegram – jag föreslår regler för din struktur.
Resultat
- Online-generatorn för robots.txt skapar en korrekt fil på fem minuter: förinställning, sökvägar, webbplatskarta, flaggor.
- Stäng administratörspanelen, papperskorgen, sök- och servicemapparna; stäng inte CSS, JS, katalogen eller bloggen.
- robots.txt tar inte bort sidor från indexet – det är vad
noindexär till för. - En komplex struktur, filter och språk är en anledning att anförtro installationen till en specialist eller bygga en webbplats på 1001site, där indexering konfigureras direkt ur lådan.
Skapa din egen robots.txt-fil nu med hjälp av den kostnadsfria robots.txt-generatorn, och om du har några frågor om reglerna, skriv till mig på Telegram.
Källor
- PromoPilots robots.txt-generatorsida — inställningar, förinställningar och sidfrågor.
- Google Search Central - Hur man skapar och skickar in en Robots.txt-fil.
- Next.js -dokumentation - robotmetadatafil.