ចម្លើយខ្លី៖ ដើម្បីបង្កើតឯកសារ robots.txt តាមអ៊ីនធឺណិត សូមបើក ម៉ាស៊ីនបង្កើត robots.txt របស់ PromoPilot ជ្រើសរើសការកំណត់ជាមុន (Custom, Allow all, Deny all, WordPress, Laravel ឬ Next.js) បញ្ចូលផ្លូវសម្រាប់ Disallow និង Allow បញ្ចូលអាសយដ្ឋានគេហទំព័រសម្រាប់បន្ទាត់ Sitemap ហើយជ្រើសរើសជម្រើស Crawl-delay or block AI crawlers។ ឯកសារដែលបានបញ្ចប់នឹងលេចឡើងនៅខាងស្តាំ—អ្នកអាចចម្លងវា ឬទាញយកវា។ វាឥតគិតថ្លៃ ហើយមិនតម្រូវឱ្យមានការចុះឈ្មោះទេ។
ខ្ញុំសរសេរ robots.txt សម្រាប់គេហទំព័រថ្មីនីមួយៗ ហើយដឹងថាវាងាយស្រួលប៉ុណ្ណាក្នុងការធ្វើខុសដោយដៃ៖ ចន្លោះបន្ថែម សញ្ញា (/) ដែលភ្លេច ឬច្បាប់នៅខាងក្រៅប្លុក។ កម្មវិធីបង្កើត robots.txt លុបបំបាត់បញ្ហានេះ - អ្នកគិតអំពី អ្វីដែល ត្រូវបិទ មិនមែនវាក្យសម្ព័ន្ធទេ។ ខាងក្រោមនេះ យើងនឹងពន្យល់ពីរបៀបប្រើវា អ្វីដែលត្រូវបិទ និងកន្លែងដែលត្រូវដាក់ឯកសារដែលបានបញ្ចប់។
តើម៉ាស៊ីនបង្កើត robots.txt មានមុខងារអ្វី?
ឧបករណ៍បង្កើតគឺជាទម្រង់មួយជំនួសឲ្យកម្មវិធីនិពន្ធអត្ថបទ។ អ្នកជ្រើសរើសការកំណត់ ហើយឧបករណ៍នឹងផ្គុំវាទៅជាឯកសារដែលមានសុពលភាព ហើយបង្ហាញវានៅក្នុងការមើលជាមុនផ្ទាល់។
| កំពុងរៀបចំ | អ្វីដែលកំណត់ | ហេតុអ្វីបានជាគេហទំព័រត្រូវការរឿងនេះ? |
|---|---|---|
| កំណត់ជាមុន | ប្ដូរតាមបំណង, អនុញ្ញាតទាំងអស់, បដិសេធទាំងអស់, WordPress, Laravel, Next.js | ចំណុចចាប់ផ្តើមដែលត្រៀមរួចជាស្រេចសម្រាប់ម៉ាស៊ីនរបស់អ្នក |
| អាសយដ្ឋានគេហទំព័រ | អាសយដ្ឋានសម្រាប់បន្ទាត់ Sitemap | មនុស្សយន្តរកឃើញផែនទីគេហទំព័រដោយខ្លួនឯង |
| មិនអនុញ្ញាតផ្លូវ | ផ្នែកដែលមិនត្រូវស្កេន មួយក្នុងមួយជួរ | មនុស្សយន្តនេះមិនខ្ជះខ្ជាយពេលវេលានៅលើផ្ទាំងគ្រប់គ្រង និងទំព័រសេវាកម្មទេ។ |
| អនុញ្ញាតផ្លូវ | ករណីលើកលែងនៅក្នុងផ្នែកបិទ | បើកឯកសារដែលចង់បាននៅក្នុងថតឯកសារដែលបិទជិត |
| ការពន្យាពេលវារ (១០ វិនាទី) | ផ្អាករវាងសំណើរបស់រ៉ូបូត | ការបន្ធូរបន្ថយបន្ទុកនៅលើម៉ាស៊ីនមេខ្សោយសម្រាប់មនុស្សយន្តដែលគិតគូរពីវា |
| ការទប់ស្កាត់ AI crawlers | ហាមឃាត់ GPTBot, Claude និង AI bot ផ្សេងទៀត | គ្រប់គ្រងអ្នកដែលប្រើប្រាស់ខ្លឹមសាររបស់អ្នក |
| មើលជាមុន ចម្លង ទាញយក | ឯកសារ robots.txt ដែលបានបញ្ចប់ | អ្នកអាចផ្ទុកឡើងវាទៅម៉ាស៊ីនបម្រើភ្លាមៗ។ |
វាជារឿងសំខាន់ក្នុងការយល់ដឹងអំពីដែនកំណត់៖ ម៉ាស៊ីនបង្កើតឯកសារមួយ ប៉ុន្តែវាមិនពិនិត្យមើលឯកសារដែលមានស្រាប់នោះទេ។ ប្រសិនបើអ្នកមានឯកសារ robots.txt រួចហើយ ហើយចង់ស្វែងរកកំហុសនៅក្នុងវា អ្នកត្រូវវិភាគឯកសារ robots.txt - អត្ថបទនៅក្នុងផ្នែកបន្ទាប់ត្រូវបានឧទ្ទិសដល់រឿងនេះ។
តើធ្វើដូចម្តេចដើម្បីបង្កើត robots.txt តាមអ៊ីនធឺណិត?
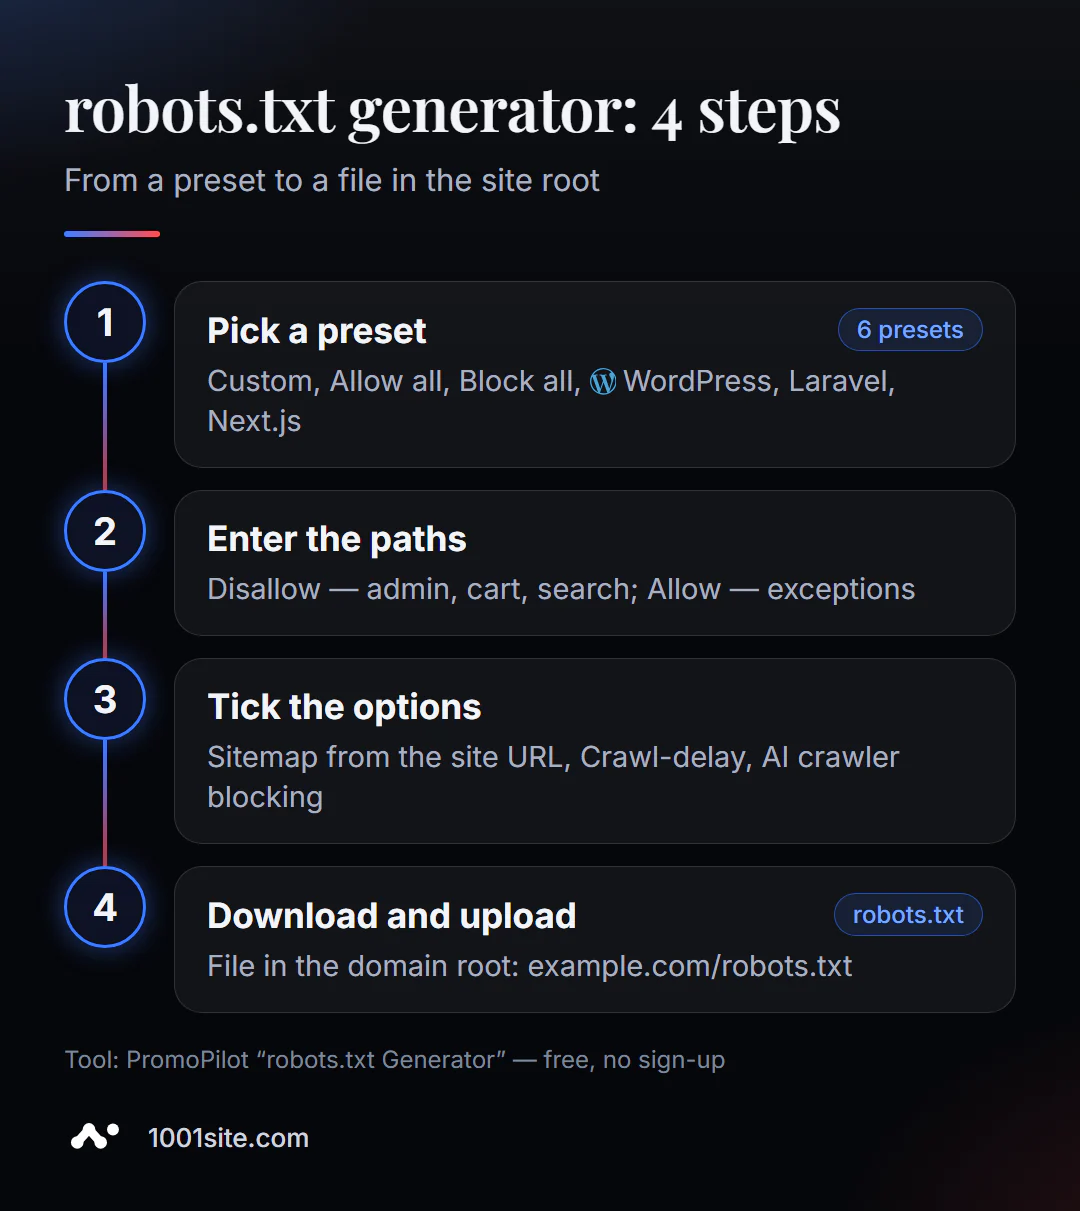
- បើក កម្មវិធីបង្កើត robots.txt ។
- ជ្រើសរើសការកំណត់ជាមុន សម្រាប់ម៉ាស៊ីនរបស់អ្នក។ ប្រសិនបើម៉ាស៊ីនរបស់អ្នកមិនមានក្នុងបញ្ជីទេ សូមជ្រើសរើស "ផ្ទាល់ខ្លួន"។
- បញ្ចូលអាសយដ្ឋានគេហទំព័រ —
https://example.com។ នេះនឹងបង្កើតបន្ទាត់Sitemap។ - បន្ថែមផ្លូវមិនអនុញ្ញាត មួយក្នុងមួយបន្ទាត់៖
/admin/,/tmp/,/search/។ - បើចាំបាច់ សូមបន្ថែម អនុញ្ញាត ករណីលើកលែង នៅក្នុងថតឯកសារដែលមានការរឹតបន្តឹង ដូចជា
/uploads/images/ជាដើម។ - ធីកប្រអប់ ៖ ផែនទីគេហទំព័រ, ការពន្យាពេលវារ, រារាំង AI crawlers។
- ចម្លង ឬទាញយកឯកសារ ហើយផ្ទុកឡើងវាទៅកាន់ root នៃគេហទំព័រ។
នៅផ្នែកខាងឆ្វេងនៃទំព័រគឺជាការកំណត់ ហើយនៅខាងស្តាំគឺជាការមើលជាមុនផ្ទាល់នៃឯកសារដែលមានប៊ូតុង "ចម្លង" និង "ទាញយក robots.txt"។
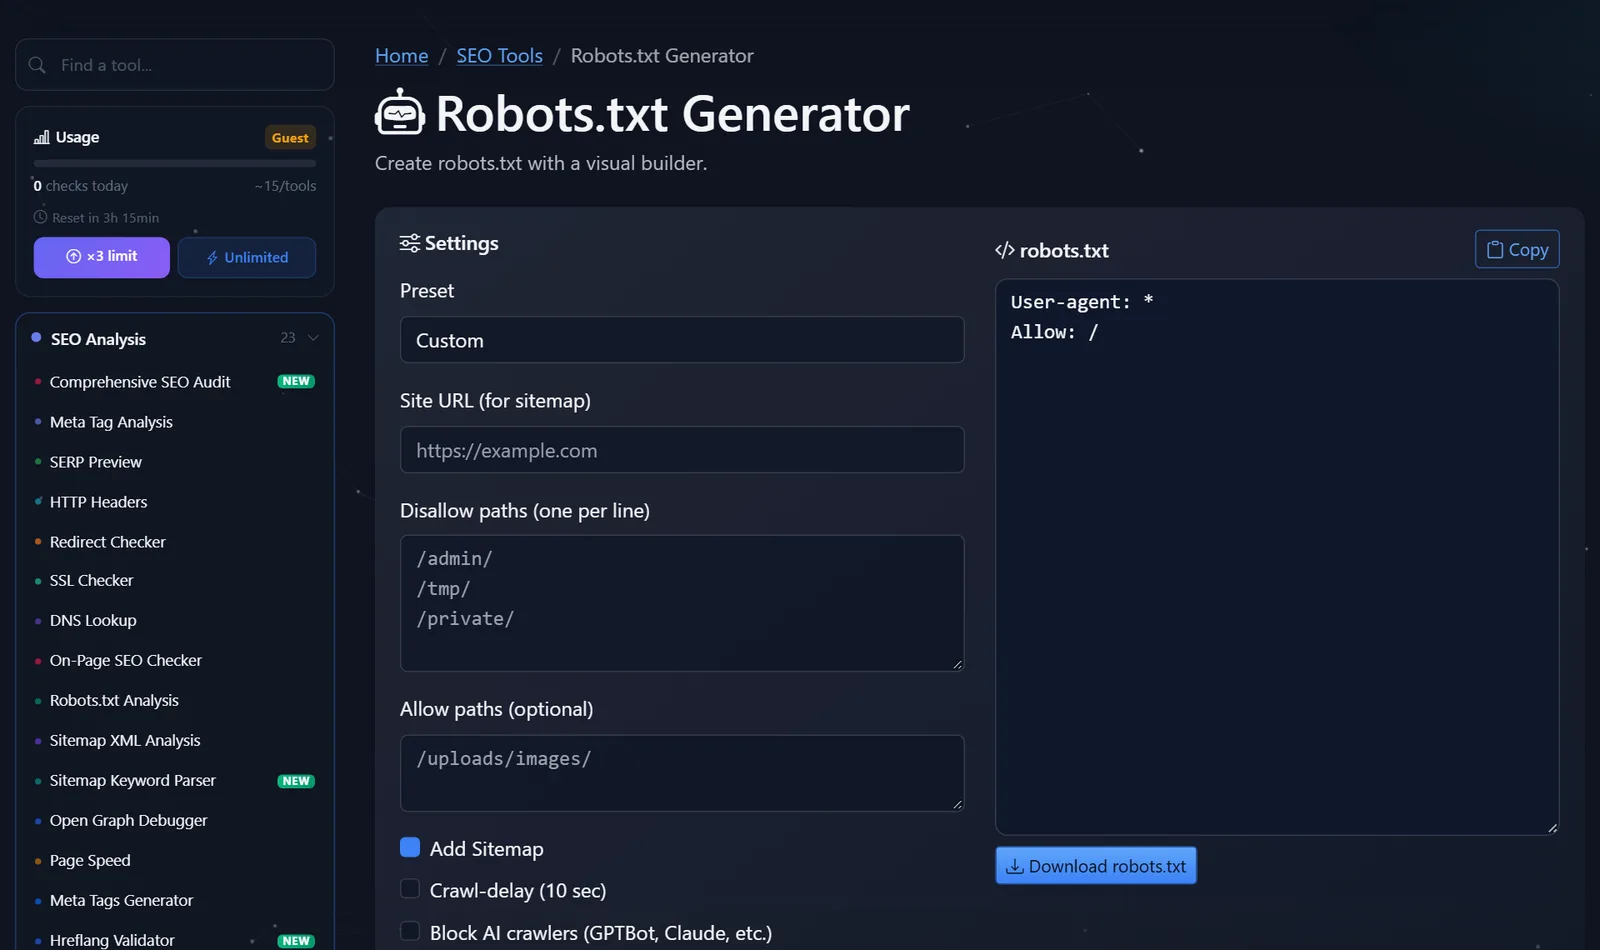
ឯកសារត្រូវតែស្ថិតនៅត្រង់ root នៃដែន៖ https://example.com/robots.txt ។ រ៉ូបូតនឹងមិនរកវាឃើញនៅក្នុងថត /blog/robots.txt ឬនៅលើដែនរងផ្សេងទៀតទេ—ដែនរងនីមួយៗមានឯកសារ robots.txt ផ្ទាល់ខ្លួន។
កន្លែងដែលត្រូវផ្ទុកឡើងឯកសារដែលបានទាញយកគឺអាស្រ័យលើវេទិកា៖
- ការបង្ហោះជាប្រចាំ - តាមរយៈកម្មវិធីគ្រប់គ្រងឯកសាររបស់បន្ទះ ឬ FTP ទៅកាន់ថតឯកសារដែលទំព័រមេស្ថិតនៅ (ជាញឹកញាប់
public_htmlឬwww)។ - WordPress — ប្រសិនបើមិនមានឯកសាររូបវន្តទេ ម៉ាស៊ីននឹងបម្រើឯកសារ robots.txt និម្មិត។ ការផ្ទុកឡើងឯកសារទៅកាន់ root នឹងជំនួសវា។ ជម្រើសទីពីរគឺប្រើកម្មវិធីនិពន្ធឯកសារនៅក្នុងកម្មវិធីជំនួយ SEO។
- Next.js និងក្របខ័ណ្ឌផ្សេងៗទៀត — ឯកសារត្រូវបានដាក់ក្នុងថតឯកសារ
publicឬបង្កើតចេញពីកូដគម្រោង ដើម្បីកុំឲ្យវាបាត់បង់ក្នុងអំឡុងពេលដាក់ពង្រាយលើកក្រោយ។ - កម្មវិធីបង្កើតគេហទំព័រ - ឯកសារជាធម្មតាត្រូវបានកែសម្រួលនៅក្នុងការកំណត់ SEO ជាជាងផ្ទុកឡើងដោយដៃ។
ឯកសារត្រូវតែដាក់ឈ្មោះថា robots.txt ជាអក្សរតូច ហើយរក្សាទុកក្នុងការអ៊ិនកូដ UTF-8 ជាអត្ថបទធម្មតា។ បន្ទាប់ពីទាញយករួច សូមបើកវានៅក្នុងកម្មវិធីរុករករបស់អ្នក៖ ប្រសិនបើអ្នកឃើញអត្ថបទរបស់អ្នក អ្វីៗគ្រប់យ៉ាងរួចរាល់ហើយ។
តើអ្វីខ្លះគួរបិទ និងមិនគួរបិទនៅក្នុង robots.txt?
គោលការណ៍ចម្បង៖ បិទអ្វីដែលមិនបន្ថែមតម្លៃដល់ការស្វែងរក និងខ្ជះខ្ជាយពេលវេលារបស់មនុស្សយន្ត។ កុំបិទអ្វីដែលចាំបាច់សម្រាប់មនុស្សយន្តដើម្បីយល់ពីទំព័រ។
ជាធម្មតាបិទ៖
- ផ្ទាំងគ្រប់គ្រង និងគណនីផ្ទាល់ខ្លួន៖
/admin/,/wp-admin/,/account/; - រទេះទិញទំនិញ និងការទូទាត់ប្រាក់៖
/cart/,/checkout/; - ការស្វែងរកខាងក្នុង៖
/search/,/?s=; - សេវាកម្ម និងថតឯកសារបណ្ដោះអាសន្ន៖
/tmp/,/cgi-bin/; - ការរួមបញ្ចូលគ្នាគ្មានទីបញ្ចប់នៃតម្រង និងជម្រើសតម្រៀប - ល្អឥតខ្ចោះ លុះត្រាតែមានទំព័រចុះចតដាច់ដោយឡែកសម្រាប់តម្រងដែលត្រូវការ។
មិនដែលបិទ៖
- CSS, JavaScript និងរូបភាព—បើគ្មានពួកវាទេ Google នឹងមិនឃើញទំព័រដូចដែលមនុស្សមើលឃើញនោះទេ។
- កាតាឡុក ប្លក់ កាតផលិតផល និងទំព័រចុះចត;
- ទំព័រដែលអ្នកចង់ដកចេញពីលិបិក្រម - សម្រាប់ការនេះអ្នកត្រូវការ
noindexហើយមនុស្សយន្តត្រូវតែអាចអានវាបាន។
នេះជាឯកសារដែលអ្នកនឹងទទួលបានសម្រាប់ហាង WordPress ធម្មតាជាមួយ WooCommerce ៖
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /cart/
Disallow: /checkout/
Disallow: /my-account/
Disallow: /?s=

Sitemap: https://example.com/sitemap.xml
ទាក់ទងនឹងទង់ជាតិ។ Google មិន គិតគូរពីការពន្យារពេលវា ទេ—បើកវាលុះត្រាតែម៉ាស៊ីនមេរបស់អ្នកកំពុងរងផលប៉ះពាល់ពីបូតផ្សេងទៀត។ ការរារាំង AI crawlers គឺជាការសម្រេចចិត្តអាជីវកម្ម៖ ប្រសិនបើអ្នកចង់ឱ្យ ChatGPT, Gemini និង Perplexity ដឹងអំពីអ្នក និងណែនាំអ្នក កុំរារាំងការចូលប្រើរបស់ពួកគេ។
ចំណុចជាក់ស្តែងមួយទៀតគឺកំណែសាកល្បងនៃគេហទំព័រ។ សម្រាប់ច្បាប់ចម្លងដំណាក់កាល សូមប្រើការកំណត់ជាមុន "បដិសេធទាំងអស់" ប៉ុន្តែត្រូវប្រាកដថាជំនួសឯកសារនៅពេលបើកដំណើរការ៖ Disallow: / ដែលភ្លេច គឺជាអ្វីដែលភាគច្រើនកាត់បន្ថយចរាចរណ៍ទៅកាន់គេហទំព័រថ្មីៗ។
ការប្រៀបធៀប៖ ម៉ាស៊ីនភ្លើង PromoPilot និងវិធីផ្សេងទៀតដើម្បីបង្កើត Robots.txt
| ផ្លូវ | តើអ្វីទៅជារបស់ឥតគិតថ្លៃ? | ការរឹតបន្តឹង | តើវាសាកសមសម្រាប់អ្នកណា? |
|---|---|---|---|
| PromoPilot — ម៉ាស៊ីនបង្កើត Robots.txt | ការកំណត់ជាមុន, មិនអនុញ្ញាត និងអនុញ្ញាត, ផែនទីគេហទំព័រ, ការពន្យាពេលវារ, ការទប់ស្កាត់បូត AI, ទាញយក | អ្នកត្រូវផ្ទុកឡើងឯកសារទៅម៉ាស៊ីនមេដោយខ្លួនឯង។ | សម្រាប់អ្នកចាប់ផ្តើមដំបូង និងអ្នកដែលមិនចង់ចាំវាក្យសម្ព័ន្ធ |
| កម្មវិធីនិពន្ធនៅក្នុងកម្មវិធីជំនួយ SEO WordPress (ឧ. Yoast SEO) | ការកែសម្រួលឯកសារដោយផ្ទាល់ពីផ្ទាំងគ្រប់គ្រង | សម្រាប់ WordPress តែប៉ុណ្ណោះ អ្នកសរសេរវាក្យសម្ព័ន្ធដោយខ្លួនឯង | សម្រាប់ម្ចាស់គេហទំព័រ WordPress |
| ឯកសាររ៉ូបូតនៅក្នុង Next.js | robots.txt ត្រូវបានបង្កើតចេញពីកូដគម្រោង | ត្រូវការអ្នកអភិវឌ្ឍន៍ | គម្រោង Next.js |
| កម្មវិធីនិពន្ធអត្ថបទ | សេរីភាពពេញលេញ | ងាយនឹងធ្វើខុស គ្មានតម្រុយ | សម្រាប់អ្នកដែលស្គាល់ស្តង់ដារដោយបេះដូង |
សេចក្តីសន្និដ្ឋាន៖ ម៉ាស៊ីនបង្កើតគឺជាមធ្យោបាយលឿនបំផុតដើម្បីទទួលបានឯកសារដែលមានសុពលភាពដោយមិនចាំបាច់ដឹងពីវាក្យសម្ព័ន្ធ។ កម្មវិធីជំនួយ និងកូដគម្រោងគឺងាយស្រួលប្រើនៅពេលដែលឯកសារត្រូវការផ្លាស់ប្តូររួមជាមួយគេហទំព័រ។
ឧបករណ៍បង្កើតនេះគឺជា ឧបករណ៍ SEO ឥតគិតថ្លៃមួយក្នុងចំណោមឧបករណ៍ចំនួន 87 របស់ PromoPilot ។ បន្ទាប់ពីទាញយកឯកសាររួច សូមពិនិត្យមើលវាជាមួយឧបករណ៍វិភាគ robots.txt ហើយសម្រាប់បន្ទាត់ផែនទីគេហទំព័រ សូមប្រើឧបករណ៍បង្កើត sitemap.xml—ទាំងពីរត្រូវបានគ្របដណ្តប់នៅក្នុងអត្ថបទជាប់គ្នានៅក្នុងផ្នែកនេះ។
ដែនកំណត់ម៉ាស៊ីនភ្លើង៖ អ្វីដែលវានឹងមិនធ្វើសម្រាប់អ្នក
ម៉ាស៊ីនភ្លើងមិនស្គាល់រចនាសម្ព័ន្ធគេហទំព័ររបស់អ្នកទេ។ ការកំណត់ជាមុន WordPress នឹងបិទផ្លូវសេវាកម្មធម្មតា ប៉ុន្តែវានឹងមិនទាយថាតម្រងហាងរបស់អ្នកស្ថិតនៅក្នុង /filter/ និងការស្វែងរកខាងក្នុងនៅក្នុង /find/ ទេ។ អ្នកនឹងត្រូវបញ្ចូលផ្លូវទាំងនេះដោយខ្លួនឯង។
វាមិនផ្ទុកឡើងឯកសារទៅកាន់ម៉ាស៊ីនមេ ឬពិនិត្យមើលថាតើឯកសារអាចចូលប្រើបាននៅ /robots.txt ជាមួយលេខកូដស្ថានភាព 200 ដែរឬទេ។ បន្ទាប់ពីផ្ទុកឡើង សូមបើកអាសយដ្ឋាននៅក្នុងកម្មវិធីរុករកតាមអ៊ីនធឺណិត ឬដំណើរការវាតាមរយៈកម្មវិធីវិភាគ។
ហើយវាមិនជំនួស noindex ទេ៖ ប្រសិនបើគោលដៅគឺដើម្បីលុបទំព័រចេញពីលទ្ធផលស្វែងរក robots.txt គឺមិនសមរម្យទេ។ ជាចុងក្រោយ ឯកសារមិនការពារទិន្នន័យរបស់អ្នកទេ៖ វាជាសាធារណៈ ហើយអ្នកណាក៏អាចអានផ្នែកណាដែលអ្នកបានចាក់សោបានដែរ។ អាថ៌កំបាំងត្រូវបានលាក់នៅពីក្រោយពាក្យសម្ងាត់។
តើពេលណាឧបករណ៍ឥតគិតថ្លៃមិនគ្រប់គ្រាន់?
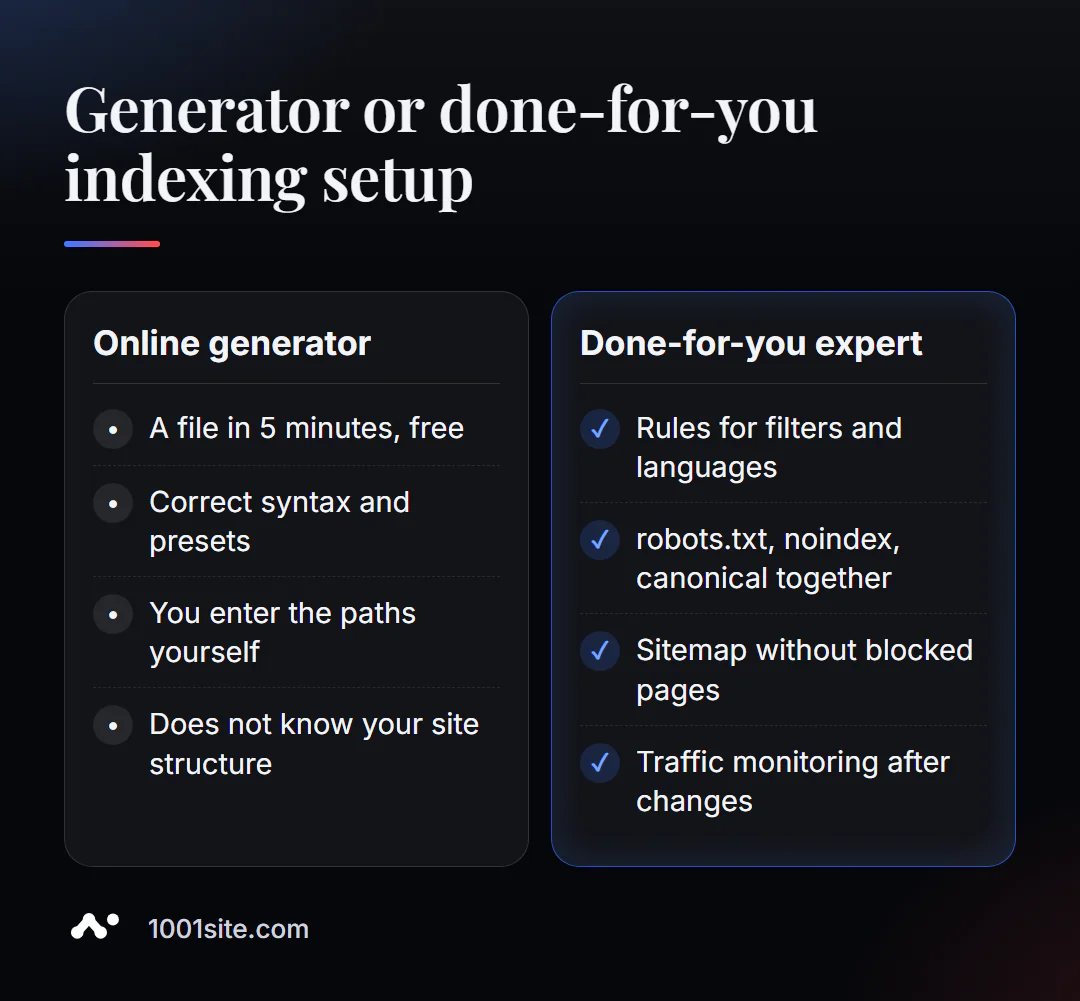
ការបង្កើតឯកសារចំណាយពេលប្រាំនាទី។ ការសម្រេចចិត្តថាត្រូវចាក់សោអ្វីនៅលើគេហទំព័រដែលមានទំព័ររាប់ពាន់គឺជាការងារច្រើន។ អ្នកត្រូវការអ្នកឯកទេសប្រសិនបើ៖
- ហាងនេះមានបន្សំតម្រងរាប់រយ ហើយខ្លះបង្កើតចរាចរណ៍។
- គេហទំព័រនេះមានច្រើនភាសា នៅលើដែនរង ឬជាមួយថតឯកសារដាច់ដោយឡែកសម្រាប់ភាសា។
- បន្ទាប់ពីកែសម្រួល robots.txt ចរាចរណ៍បានធ្លាក់ចុះ ហើយវាមិនច្បាស់ថាច្បាប់មួយណាដែលត្រូវស្តីបន្ទោសនោះទេ។
- អ្នកត្រូវតម្រឹម robots.txt, meta tags, canonical និង sitemap ទៅក្នុងប្រព័ន្ធតែមួយ។
តើខ្ញុំអាចធ្វើអ្វីបានសម្រាប់គេហទំព័ររបស់អ្នក?
ខ្ញុំឈ្មោះ Valeriy Danyuk ខ្ញុំជាអ្នកអភិវឌ្ឍន៍ និងជាអ្នកឯកទេស SEO ដែលមានបទពិសោធន៍ 12 ឆ្នាំ និងមានអតិថិជនជាង 200 នាក់។ ឯកសារ robots.txt ត្រឹមត្រូវមួយគឺជាផ្នែកមួយនៃគេហទំព័រនីមួយៗដែលខ្ញុំបង្កើត។
SEO និងការផ្សព្វផ្សាយ
- ការធ្វើសវនកម្ម SEO ប្រកបដោយប្រសិទ្ធភាព ៖ robots.txt, noindex, canonical និង sitemap ជាប្រព័ន្ធបង្រួបបង្រួម មិនមែនជាសំណុំនៃច្បាប់ចៃដន្យទេ។
- ប្លក់ SEO ដែលដំណើរការដោយ AI ដែលនាំមកនូវអ្នកនាំមុខសរីរាង្គ ។
- គេហទំព័រពហុភាសាដែលគ្មានអ្នកបកប្រែ — ដែល robots.txt និង sitemap ត្រូវតែគិតគូរពីគ្រប់ភាសាទាំងអស់។
គេហទំព័រ និងហាងលក់ទំនិញអនឡាញ
- ហាងអនឡាញ WooCommerce ៖ គំរូជាង ៤០, ២៩៩ អឺរ៉ូ — ជាមួយ robots.txt សម្រាប់រទេះទិញទំនិញ តម្រង និងការទូទាត់ប្រាក់។
- គេហទំព័រមួយនៅលើ 1001site ដែលផែនទីគេហទំព័រ និងការធ្វើលិបិក្រមត្រូវបានកំណត់រចនាសម្ព័ន្ធដោយស្វ័យប្រវត្តិ។ តើវាខុសគ្នាយ៉ាងដូចម្តេចពីអ្នកបង្កើតដែលមានថ្លៃជាវ? ការវិភាគ គេហទំព័រ Tilda ទល់នឹង AI ។
CRM, គណនេយ្យ និង ស្វ័យប្រវត្តិកម្ម
- ប្រព័ន្ធគណនេយ្យប្រចាំខែសម្រាប់ហាងអនឡាញ - គម្រោងសម្រាប់ក្រុមហ៊ុនមួយមកពីសាធារណរដ្ឋឆែក។
- QuestFlow គឺជាកម្មវិធីបង្កើត SaaS Telegram ជាមួយ AI ។
មានច្រើនទៀតនៅក្នុង ផលប័ត្រ ។ មិនប្រាកដថាត្រូវគ្របដណ្តប់លើអ្វីទេ? ផ្ញើអាសយដ្ឋានគេហទំព័ររបស់អ្នកមកខ្ញុំ នៅក្នុង Telegram - ខ្ញុំនឹងណែនាំច្បាប់សម្រាប់រចនាសម្ព័ន្ធរបស់អ្នក។
លទ្ធផល
- ម៉ាស៊ីនបង្កើត robots.txt លើអ៊ីនធឺណិតបង្កើតឯកសារត្រឹមត្រូវក្នុងរយៈពេលប្រាំនាទី៖ កំណត់ជាមុន ផ្លូវ ផែនទីគេហទំព័រ ទង់។
- បិទផ្ទាំងគ្រប់គ្រង ធុងសំរាម ការស្វែងរក និងថតសេវាកម្ម។ កុំបិទ CSS, JS, កាតាឡុក ឬប្លក់។
- robots.txt មិនលុបទំព័រចេញពីលិបិក្រមទេ - នេះជាអ្វីដែល
noindexមានសម្រាប់។ - រចនាសម្ព័ន្ធ តម្រង និងភាសាស្មុគស្មាញ គឺជាហេតុផលមួយដើម្បីប្រគល់ការដំឡើងទៅឱ្យអ្នកឯកទេស ឬ បង្កើតគេហទំព័រនៅលើ 1001site ដែលការធ្វើលិបិក្រមត្រូវបានកំណត់រចនាសម្ព័ន្ធចេញពីប្រអប់។
បង្កើតឯកសារ robots.txt ផ្ទាល់ខ្លួនរបស់អ្នកឥឡូវនេះដោយប្រើ ម៉ាស៊ីនបង្កើត robots.txt ឥតគិតថ្លៃ ហើយប្រសិនបើអ្នកមានសំណួរអំពីច្បាប់ សូមសរសេរមកខ្ញុំនៅលើ Telegram ។
ប្រភព
- ទំព័រឧបករណ៍បង្កើត robots.txt របស់ PromoPilot — ការកំណត់ ការកំណត់ជាមុន និងសំណួរទំព័រ។
- មជ្ឈមណ្ឌលស្វែងរក Google - របៀបបង្កើត និងដាក់ស្នើឯកសារ Robots.txt។
- ឯកសារ Next.js - ឯកសារទិន្នន័យមេតារបស់រ៉ូបូត។