छोटो उत्तर: लुकेका अक्षरहरूको लागि पाठ जाँच गर्न, यसलाई प्रोमोपाइलट वाटरमार्क डिटेक्टरमा टाँस्नुहोस् र "चेक गर्नुहोस्" मा क्लिक गर्नुहोस्। एक सेकेन्डमा, यसले शून्य-चौडाइ वर्णहरू (U+200B, U+FEFF, U+2060, र अन्य), होमोग्लिफहरू (विदेशी वर्णमालाका अक्षरहरू जुन नाङ्गो आँखाले छुट्याउन सकिँदैन), अदृश्य ढाँचा, र स्टेगानोग्राफिक इन्सर्टहरू फेला पार्नेछ। एक क्लिकमा, तपाईंले पाठको सफा गरिएको प्रतिलिपि पाउनुहुनेछ। नि:शुल्क र दर्ता आवश्यक छैन।
मेरो अनुभवमा, यो "अस्पष्ट" बगहरूको एक सामान्य कारण हो: साइट खोजीद्वारा श्रेणी शीर्षक फेला पर्दैन, यद्यपि शब्द सही हिज्जे गरिएको छ - र यसको भित्र, मेसेन्जरबाट पाठको साथ आएको शून्य-चौडाइ वर्ण छ।
वाटरमार्क डिटेक्टरले टेक्स्टमा के फेला पार्छ?
यो उपकरणले कुनै पाठ AI द्वारा लेखिएको हो कि होइन भनेर मूल्याङ्कन गर्दैन—एआई डिटेक्टरले त्यही गर्छ, र यस श्रृंखलामा यसको बारेमा छुट्टै लेख छ। यहाँ लक्ष्य फरक छ: पाठमा भौतिक रूपमा उपस्थित तर नाङ्गो आँखाले अदृश्य के छ भनेर पत्ता लगाउनु।
| लेबलको प्रकार | उदाहरण | तपाईंलाई के ले रोकिरहेको छ? |
|---|---|---|
| शून्य-चौडाइका वर्णहरू | U+200B (शून्य चौडाइ स्पेस), U+2060 (शब्द जोड्ने) | शब्द आन्तरिक रूपमा विभाजित हुन्छ: खोज र किवर्डहरू मेल खाँदैनन्। |
| BOM र सेवा प्रतीकहरू | रेखाको सुरु वा बीचमा U+FEFF | हेडरहरू, CSV, कोड र टेम्प्लेटहरू तोड्छ |
| समरूप अक्षरहरू | सिरिलिक "a" (U+0430) को सट्टा ल्याटिन "a" (U+0061) | शब्द सही देखिन्छ, तर खोजको लागि यो फरक शब्द हो। |
| अदृश्य ढाँचा | लुकेका पाठ निर्देशन नियन्त्रण वर्णहरू | प्रतिलिपि र टाँस्दा अनौठो वर्ण क्रम |
| स्टेगानोग्राफिक इन्सर्टहरू | एन्कोड गरिएको लेबलको साथ अदृश्य वर्णहरूको अनुक्रमहरू | पाठ कहाँबाट प्रतिलिपि गरिएको थियो भनेर ट्र्याक गर्न तिनीहरू प्रयोग गर्न सकिन्छ। |
परिणामस्वरूप फेला परेका ट्यागहरूको विस्तृत रिपोर्ट (५ प्रकारसम्म) र पाठको सफा गरिएको संस्करण प्राप्त हुन्छ। भाषाहरू: अंग्रेजी, रूसी, युक्रेनी।
लुकेका अक्षरहरूको लागि अनलाइन पाठ कसरी जाँच गर्ने?
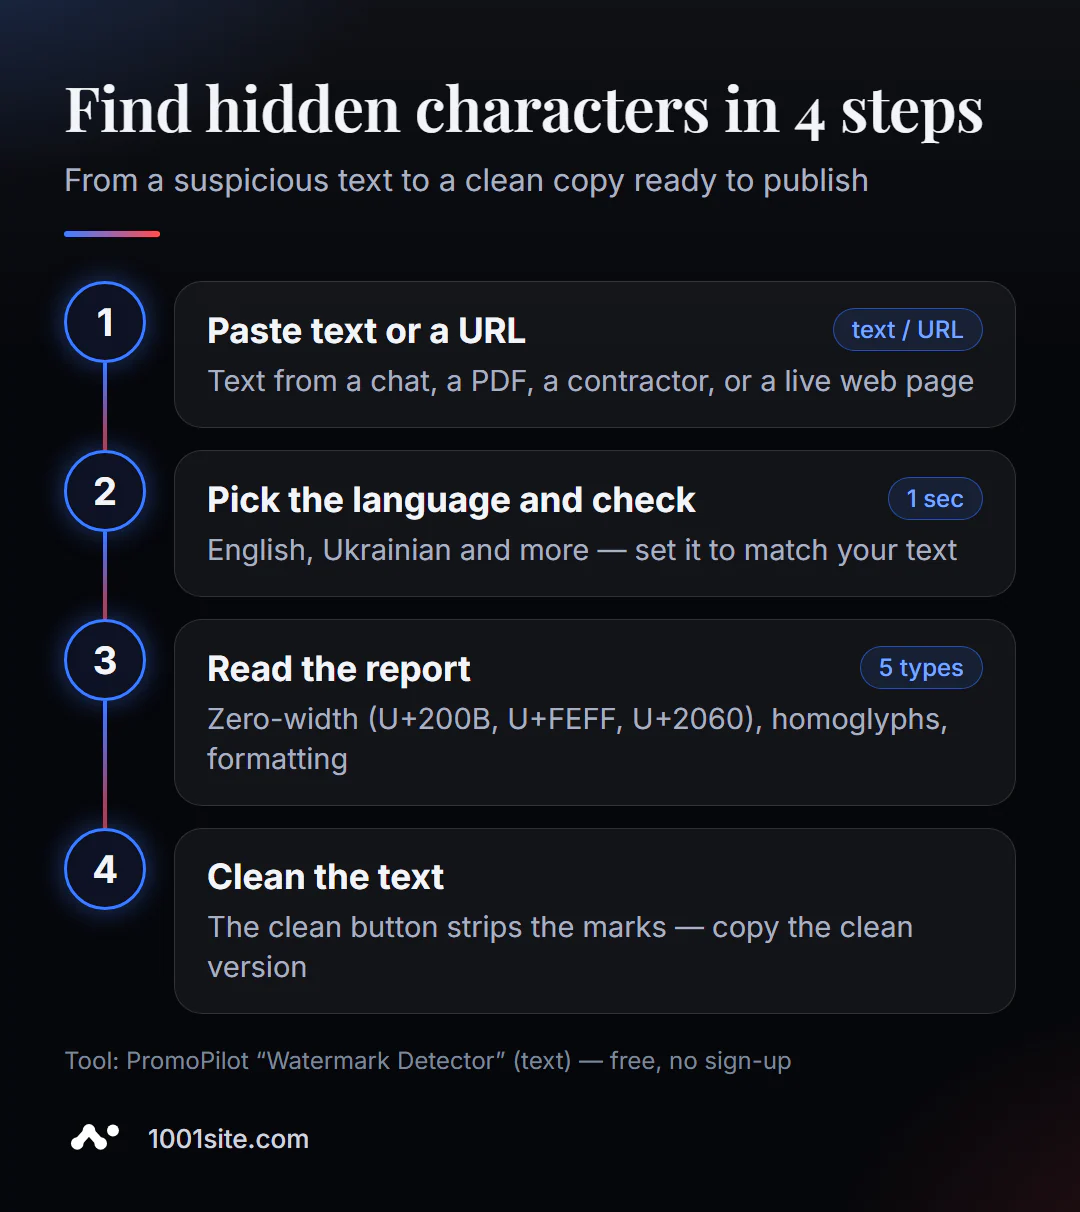
- वाटरमार्क डिटेक्टर खोल्नुहोस् - ब्राउजरमा काम गर्छ।
- प्रकाशित पृष्ठ जाँच गर्न पाठ टाँस्नुहोस् वा "URL बाट डाउनलोड गर्नुहोस्" चयन गर्नुहोस्।
- भाषा चयन गर्नुहोस् — पूर्वनिर्धारित रूपमा अंग्रेजी; रूसी पाठको लागि, म्यानुअल रूपमा स्विच गर्नुहोस्।
- "जाँच गर्नुहोस्" मा क्लिक गर्नुहोस् र रिपोर्ट जाँच गर्नुहोस्: कुन प्रतीकहरू भेटिए र कहाँ।
- स्पष्ट बटनमा क्लिक गर्नुहोस् र पाठको सफा संस्करण प्रतिलिपि गर्नुहोस्।
पृष्ठ यस्तो देखिन्छ: पाठ क्षेत्र, URL द्वारा लोड हुँदै, भाषा चयन, र उपकरणले जाँच गर्ने कुराहरूको सूची।
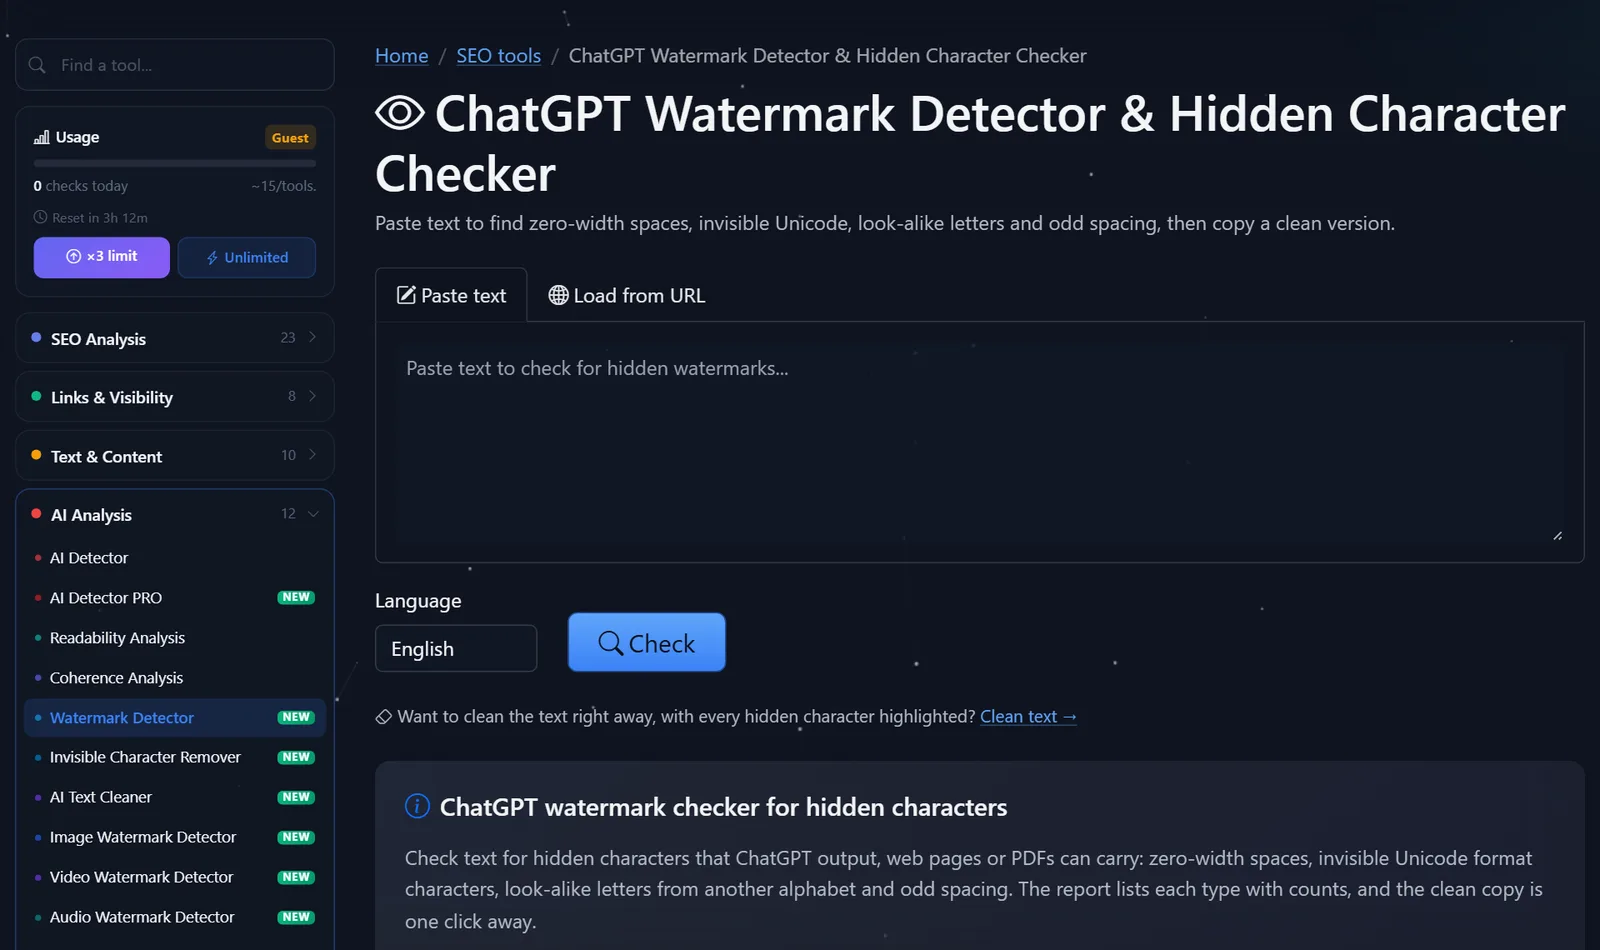
पाहुनाहरूले प्रति दिन लगभग १५ वटा चेकहरूमा पहुँच पाउँछन्; नि:शुल्क दर्ता पछि, उनीहरूले तीन गुणा बढी चेक गर्न सक्छन्।
पाठमा लुकेका प्रतीकहरू कहाँबाट आउँछन् र तिनीहरूलाई के गर्ने?
प्रायः, अदृश्य वस्तुहरू दुर्भावनापूर्ण नियतले होइन, तर प्रतिलिपि गरेर देखा पर्छन्:
- एआई च्याट र मेसेन्जरहरूबाट, सेवा स्थानहरू र प्रतीकहरू प्रतिक्रिया ढाँचासँगै लगिन्छन्।
- PDF र Word बाट - हाइफन, सफ्ट हाइफन, नन-ब्रेकिंग स्पेस र BOM।
- अन्य साइटहरूबाट - कहिलेकाहीं जानाजानी: यसरी तिनीहरूले सामग्रीलाई प्रतिलिपि हुनबाट जोगाउँछन् र यो कहाँ देखिन्छ भनेर ट्र्याक गर्छन्।
- प्रतिलिपि लेखक वा ठेकेदारबाट - कहिलेकाहीं विशिष्टता जाँचहरू "धोखा" दिन होमोग्लिफहरू प्रयोग गरिन्छ।
रिपोर्टलाई के गर्ने:
- शीर्षक, URL र मेटा ट्यागहरूबाट सधैं शून्य-चौडाइ क्यारेक्टरहरू र BOM हरू हटाउनुहोस्। कुनै पनि परिस्थितिमा तिनीहरूको त्यहाँ कुनै स्थान छैन।
- मुख्य पाठमा भएका होमोग्लिफहरू हटाइनुपर्छ र तिनीहरूको उत्पत्तिको अनुसन्धान गर्नुपर्छ। यदि पाठ प्रतिलिपि लेखकद्वारा पेश गरिएको हो भने, होमोग्लिफहरू चिन्ताको कारण हुनुपर्छ: यो विशिष्टतालाई प्रतिस्थापन गर्ने एक क्लासिक प्रविधि हो।
- नम्बर र एकाइ बीचको नब्रेक्ने खाली ठाउँहरू ("५ €," "१० मिनेट") छोड्न सकिन्छ। यो सामान्य टाइपोग्राफी हो, र उपकरण ह्युरिस्टिक छ र तिनीहरूलाई शंकास्पदको रूपमा फ्ल्याग गर्न सक्छ।
- अरू कसैको पाठमा स्टेगानोग्राफिक इन्सर्टहरू लेखकले प्रतिलिपिहरू निगरानी गरिरहेको संकेत हो। यसलाई सेनिटाइज नगर्नु राम्रो हो, तर आफ्नै पाठ लेख्नु राम्रो हो: ट्यागहरू मुख्य मुद्दा होइनन्; मुख्य भनेको प्रतिलिपि अधिकार हो।
लुकेका क्यारेक्टरहरूले SEO लाई कसरी असर गर्छ?
अदृश्य पात्र "डिजाइन त्रुटि" होइन, तर वास्तविक प्राविधिक समस्या हो। यहाँ यो सबैभन्दा बढी प्रभावित हुन्छ:
- शीर्षक र H1। U+200B भएको "डेलिभरी" शब्द खोज इन्जिनहरूलाई दुई टुक्राको रूपमा देखिन्छ: "dost" र "avka"। पृष्ठ क्वेरीसँग कम राम्रोसँग मेल खान्छ, र कहिलेकाहीं स्निपेटमा एउटा अनौठो खाडल देखा पर्दछ।
- URL र स्लग। यदि अदृश्य ट्याग भएको शीर्षक स्वचालित रूपमा पृष्ठ ठेगानामा रूपान्तरण भयो भने, URL मा
%E2%80%8Bजस्ता एन्कोड गरिएको फोहोर हुनेछ। यो लिङ्क प्रतिलिपि गर्न गाह्रो छ र शंकास्पद देखिन्छ। - संरचित डेटा र फिडहरू। उत्पादनको नाममा BOM प्रतीक वा होमोग्लिफले बजार वा व्यापारी केन्द्र फिडलाई तोड्न सक्छ, र उत्पादनले मोडरेसन पास गर्दैन।
- वेबसाइटमा खोज्नुहोस् र फिल्टर गर्नुहोस्। ग्राहकले "केबल" खोज्छ, तर उत्पादन सूचीमा "e" सहित "केबल" लेखिएको हुन्छ—वस्तु अवस्थित भए तापनि त्यो फेला पर्दैन।
- एआई सहायक प्रतिक्रियाहरू। मोडेलहरूले प्रतिस्थापन गरिएका अक्षरहरू भएका शब्दहरू गलत पहिचान गर्न सक्छन्, जसको अर्थ तपाईंको पाठ प्रयोगकर्ताको प्रश्नसँग मेल खाने सम्भावना कम हुनेछ।
त्यसैले म शीर्षक, ठेगाना र उत्पादन कार्डहरूमा आउने सबै कुराहरू अदृश्य छन् कि छैनन् भनेर जाँच गर्छु, विशेष गरी थोक आयातको समयमा।
के उपकरणले ChatGPT र SynthID वाटरमार्कहरू फेला पार्नेछ?
पाठमा दुई प्रकारका वाटरमार्कहरू बीचको भिन्नता छुट्याउन महत्त्वपूर्ण छ।
पाठमा प्रतीकात्मक वर्णहरू प्रतीकहरूको रूपमा पाइन्छन्: अदृश्य वर्णहरू, होमोग्लिफहरू, र ढाँचा। प्रोमोपाइलट डिटेक्टरले तिनीहरूलाई फेला पार्छ र हटाउँछ।
तथ्याङ्कीय चिन्हहरू जेनेरेसनको समयमा प्रयोग गरिने शब्द छनोटमा नै निर्मित हुन्छन्। उदाहरणका लागि, Google आफ्नो मोडेलहरूको पाठमा SynthID वाटरमार्क इम्बेड गर्छ र यसलाई छुट्टै पोर्टल, SynthID डिटेक्टरमा जाँच गर्छ। यो वाटरमार्क "स्पष्ट" बटनले हटाउन सकिँदैन: यो प्रतीक होइन, तर शब्दमा रहेको ढाँचा हो। न त यो उपकरणले न त अन्य प्रतीक जाँचकर्ताहरूले यसलाई पत्ता लगाउनेछन्।
त्यसकारण, "सफा गरिएको" पाठ "एआई डिटेक्टरहरूको लागि अदृश्य" हुँदैन - र यो हुनु हुँदैन। सफाईको उद्देश्य वेबसाइटमा पाठ सही रूपमा काम गर्दछ भनेर सुनिश्चित गर्नु हो: यो खोजी योग्य छ, प्रतिलिपि गरिएको छ, र सही रूपमा प्रदर्शित छ।
तुलना: प्रोमोपाइलट वाटरमार्क डिटेक्टर र विकल्पहरू
| उपकरण | के नि:शुल्क छ? | प्रतिबन्धहरू | यो कसको लागि उपयुक्त छ? |
|---|---|---|---|
| प्रोमोपाइलट — टेक्स्ट वाटरमार्क डिटेक्टर | ५ प्रकारका ट्यागहरू खोज्नुहोस्, रिपोर्ट गर्नुहोस्, एक-क्लिक सफाई गर्नुहोस्, URL जाँच गर्नुहोस् | सादा पाठ मात्र, DOC/PDF छैन; दैनिक अतिथि सीमा | लेखकहरू, सम्पादकहरू, र वेबसाइट मालिकहरूका लागि |
| कोड सम्पादक (जस्तै VS कोड) | अदृश्य र समान प्रतीकहरू हाइलाइट गर्दै | तपाईंले प्रोग्राम स्थापना गर्नुपर्छ र यसलाई म्यानुअल रूपमा सफा गर्नुपर्छ। | विकासकर्ताहरूको लागि |
| नियमित अभिव्यक्ति खोजी | सम्पादकमा [-] खोज्नुहोस् | यसरी होमोग्लिफहरू फेला पार्न सकिँदैन; तपाईंलाई सीप चाहिन्छ। | धेरै मात्रामा पाठसँग काम गर्नेहरूका लागि |
| Google सिन्थआईडी डिटेक्टर | SynthID वाटरमार्क प्रमाणीकरण | Google एआई सामग्री मात्र; पहुँच सीमित | पत्रकार र अनुसन्धानकर्ताहरूको लागि |
निष्कर्ष: प्रकाशन अघि दैनिक पाठ जाँचको लागि, अनलाइन डिटेक्टर सबैभन्दा सुविधाजनक छ - यसले प्रतीक र होमोग्लिफ दुवै फेला पार्छ र तुरुन्तै सफा प्रतिलिपि उत्पादन गर्दछ।
प्रोमोपाइलटको क्याटलगमा ८७ नि:शुल्क SEO उपकरणहरू छन्, जसमा छवि, भिडियो र अडियोका लागि समर्पित वाटरमार्क डिटेक्टरहरू समावेश छन्; प्रत्येकलाई यस ब्लग खण्डको छुट्टै लेखमा समेटिएको छ।
वाटरमार्कको लागि पाठ जाँच गर्ने सीमाहरू?
- सादा पाठ मात्र। बाइनरी DOC र PDF फाइलहरू समर्थित छैनन्—तिनीहरूबाट पाठ प्रतिलिपि गरेर टाँस्नुहोस्।
- ह्युरिस्टिक्स: शंकास्पद पात्र सधैं हानिकारक हुँदैन: नटुट्ने ठाउँ वा नरम हाइफन उपयुक्त हुन सक्छ।
- तथ्याङ्कीय वाटरमार्कहरू देखिँदैनन्। उपकरणले शब्दहरूमा ढाँचा होइन, प्रतीकहरू खोज्छ।
- सफाई गर्दैमा पाठ अद्वितीय हुँदैन। यदि पाठ अरू कसैको हो भने, सफा गरेपछि पनि यो अरू कसैको नै रहन्छ।
कहिले नि:शुल्क उपकरण पर्याप्त हुँदैन?
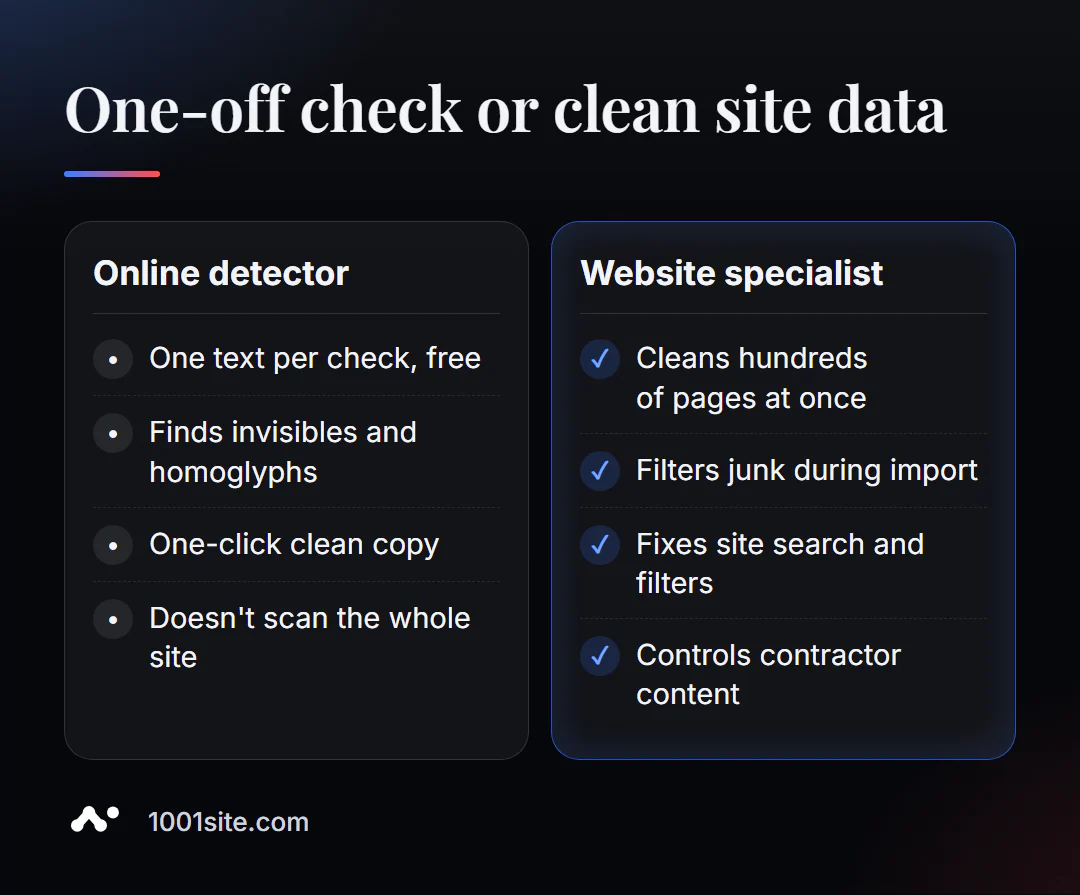
एक पटकको समीक्षाले एउटा पाठको समस्या समाधान गर्छ। निम्न अवस्थामा विशेषज्ञको आवश्यकता पर्दछ:
- लुकेका प्रतीकहरू पहिले नै सयौं उत्पादन कार्ड र लेखहरूमा वितरण गरिएको छ;
- सामग्री साइटमा स्ट्रिमको रूपमा आउँछ - ठेकेदारहरू, एआई, र सामाजिक सञ्जालहरूबाट आयातहरूबाट;
- साइट खोज र फिल्टरहरूले अनौठो व्यवहार गर्छन् र कारण स्पष्ट छैन;
- हामीलाई आयात गर्दा स्वचालित पाठ सफाई चाहिन्छ, म्यानुअल होइन।
तपाईंको वेबसाइटको लागि म के गर्न सक्छु?
म भ्यालेरी डान्युक हुँ, १२ वर्षको अनुभव र २०० भन्दा बढी ग्राहकहरू भएको एक विकासकर्ता र SEO विशेषज्ञ। डेटा अखण्डता मैले सिर्जना गर्ने हरेक निर्माणको एक प्रमुख भाग हो: आयात, क्याटलग, र स्वचालन।
SEO र सामग्री
- टर्नकी वेबसाइट एसईओ अडिट: म एउटा पृष्ठमा मात्र नभई सम्पूर्ण साइटमा टुटेका शीर्षकहरू, डुप्लिकेटहरू, र टुटेका डेटा फेला पार्छु।
- अर्गानिक ग्राहकहरूलाई आकर्षित गर्ने SEO ब्लग - प्रकाशन अघि AI-संचालित पाठहरूको समीक्षा गरिन्छ।
वेबसाइट र निर्देशिकाहरू
- MCP र Claude मार्फत केही मिनेटमा ३००-उत्पादनहरूको सूची - डेटा बर्बाद बिना थोक आयात।
- Instagram वेबसाइटमा स्टोर स्थानान्तरण गर्दा, सामाजिक सञ्जालका पाठहरू पनि सफा गर्नुपर्छ।
- €२९९ मा AI सहायक भएको WordPress वेबसाइट वा लिङ्क मार्फत सामग्री स्थानान्तरण भएको 1001site वेबसाइट।
स्वचालन
- स्वचालित रूपमा मूल्य गणना गर्ने र बीजकहरू छाप्ने CRM एउटा उदाहरण हो जहाँ सफा डेटा सर्वोपरि हुन्छ।
- क्वेस्टफ्लो एआई भएको Telegram बट निर्माता हो ।
यदि साइटले त्यहाँ निश्चित रूपमा भएको कुरा "फेला पार्न सकेन" भने, मलाई Telegram लेख्नुहोस्, र हामी कारण पत्ता लगाउनेछौं।
नतिजा
- लुकेका प्रतीकहरू र होमोग्लिफहरू आँखाले देख्न सकिँदैनन्, तर तिनीहरूले खोजहरू, शीर्षकहरू र किवर्डहरू तोड्छन्।
- वाटरमार्क डिटेक्टरले ५ प्रकारका चिन्हहरू फेला पार्छ र एक क्लिकमा सफा गरिएको पाठ नि:शुल्क प्रदान गर्दछ।
- तथ्याङ्कीय एआई वाटरमार्कहरू (जस्तै सिन्थआईडी) प्रतीकहरूमा इम्बेड गरिएका हुँदैनन्; तिनीहरू अन्य उपकरणहरूद्वारा जाँच गरिन्छन्।
- यदि "फोहोर" पहिले नै साइटभरि फैलिएको छ भने, पूर्ण डेटा सफा गर्न आवश्यक छ - वा 1001site मा सावधानीपूर्वक आयात गरिएको नयाँ साइट।
तपाईंको अर्को पोस्ट गर्नु अघि , लुकेका अक्षरहरूको लागि तपाईंको पाठ जाँच गर्नुहोस्, विशेष गरी यदि यो च्याट वा PDF बाट आएको हो भने।
स्रोतहरू
- प्रोमोपाइलटको वाटरमार्क डिटेक्टर उपकरण पृष्ठ — वाटरमार्क प्रकारहरू, सीमितताहरू, उदाहरण।
- Google - सिन्थआईडी डिटेक्टर पोर्टलको घोषणा।
- युनिकोड मानक - शून्य-चौडाइ वर्णहरू र विशेष वर्णहरूको लागि कोडहरू।