थोडक्यात उत्तर: मजकुरातील छुपे वर्ण तपासण्यासाठी, तो प्रोमोपायलट वॉटरमार्क डिटेक्टरमध्ये पेस्ट करा आणि "चेक" वर क्लिक करा. फक्त एका सेकंदात, ते झिरो-विड्थ कॅरेक्टर्स (U+200B, U+FEFF, U+2060 आणि इतर), होमोग्लिफ्स (परकीय वर्णमालेतील अशी अक्षरे जी उघड्या डोळ्यांना ओळखता येत नाहीत), अदृश्य फॉरमॅटिंग आणि स्टेगनोग्राफिक इन्सर्ट्स शोधून काढेल. एका क्लिकवर, तुम्हाला मजकुराची स्वच्छ केलेली प्रत मिळेल. मोफत आणि कोणत्याही नोंदणीची आवश्यकता नाही.
माझ्या अनुभवानुसार, "अस्पष्ट" त्रुटींचे हे एक सामान्य कारण आहे: शब्दाची स्पेलिंग बरोबर लिहिलेली असूनही, श्रेणीचे शीर्षक साइट सर्चमध्ये सापडत नाही—आणि त्यामध्ये, मेसेंजरकडून आलेल्या मजकुरासोबत एक शून्य-रुंदीचे अक्षर (zero-width character) असते.
वॉटरमार्क डिटेक्टर मजकुरात काय शोधतो?
हे साधन एखादा मजकूर एआयने लिहिला आहे की नाही याचे मूल्यांकन करत नाही—ते काम एआय डिटेक्टर करतो, आणि या मालिकेत त्याबद्दल एक स्वतंत्र लेख आहे. येथील उद्दिष्ट वेगळे आहे: मजकुरात भौतिकरित्या उपस्थित असलेल्या परंतु उघड्या डोळ्यांना अदृश्य असलेल्या गोष्टी शोधणे.
| लेबल प्रकार | उदाहरण | तुम्हाला कशामुळे अडचण येत आहे? |
|---|---|---|
| शून्य-रुंदीचे वर्ण | U+200B (शून्य रुंदीची जागा), U+2060 (शब्द जोडणारा) | शब्दांची अंतर्गत विभागणी: शोध आणि कीवर्ड जुळत नाहीत |
| बीओएम आणि सेवा चिन्हे | ओळीच्या सुरुवातीला किंवा मध्यभागी U+FEFF | हेडर, CSV, कोड आणि टेम्पलेट्स खंडित करते |
| होमोग्लिफ्स | सिरिलिक “a” (U+0430) ऐवजी लॅटिन “a” (U+0061) | शब्द बरोबर वाटतो, पण शोधासाठी तो वेगळाच शब्द आहे. |
| अदृश्य स्वरूपण | लपवलेले मजकूर दिशा नियंत्रण वर्ण | कॉपी आणि पेस्ट करताना अक्षरांचा विचित्र क्रम |
| स्टेगनोग्राफिक इन्सर्ट्स | एन्कोड केलेल्या लेबलसह अदृश्य वर्णांचे क्रम | मजकूर कुठून कॉपी केला गेला याचा मागोवा घेण्यासाठी त्यांचा वापर केला जाऊ शकतो. |
परिणाम म्हणजे सापडलेल्या टॅग्जचा (५ प्रकारांपर्यंत) तपशीलवार अहवाल आणि मजकुराची स्वच्छ केलेली आवृत्ती. भाषा: इंग्रजी, रशियन, युक्रेनियन.
ऑनलाइन मजकुरातील छुपी अक्षरे कशी तपासावी?
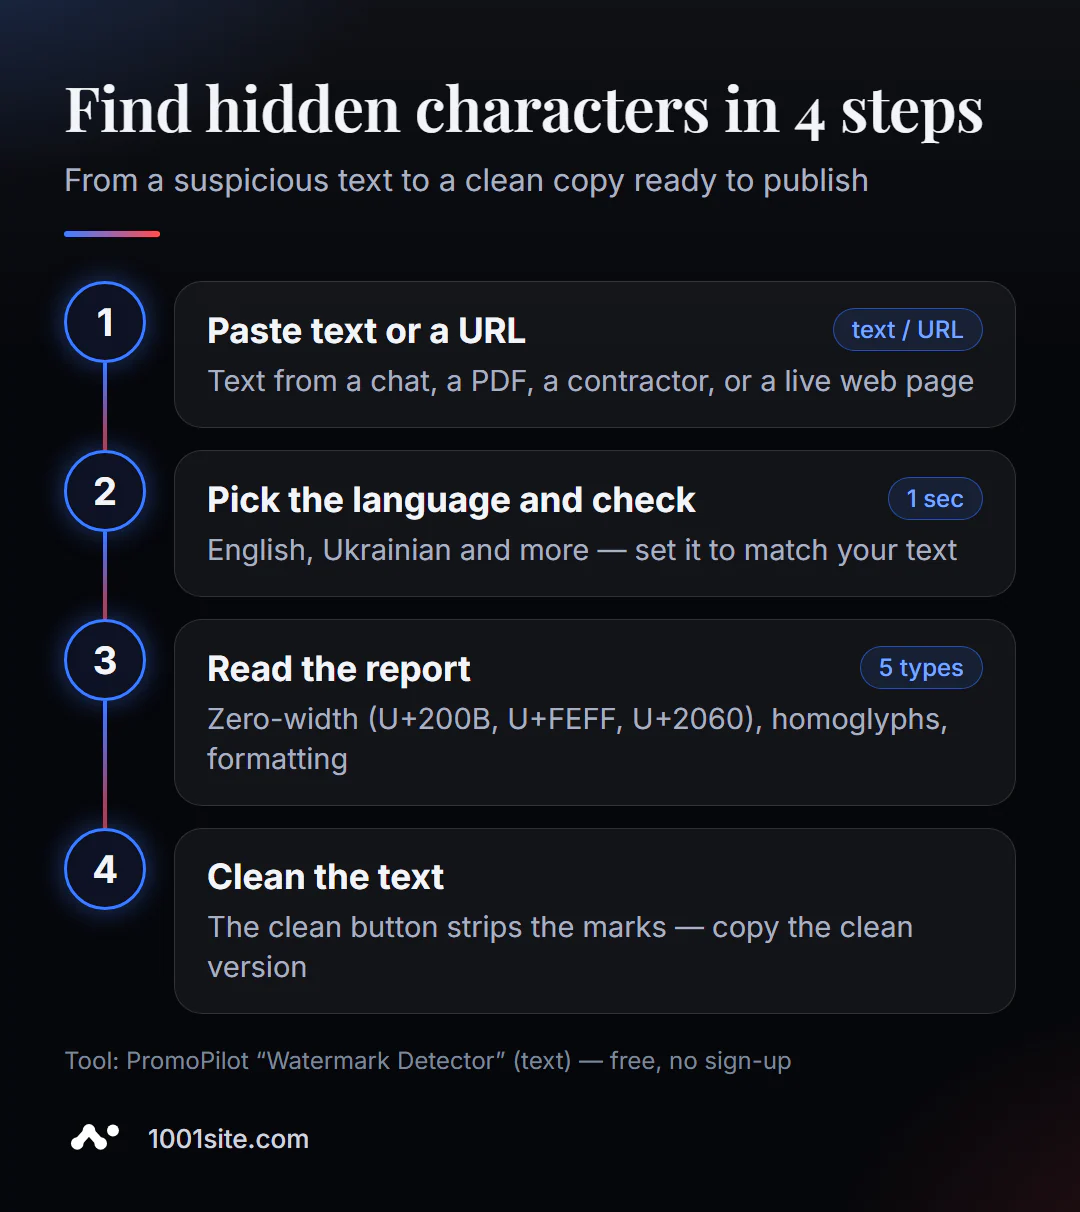
- वॉटरमार्क डिटेक्टर उघडा - हे ब्राउझरमध्ये काम करते.
- प्रकाशित पृष्ठ तपासण्यासाठी मजकूर पेस्ट करा किंवा "URL वरून डाउनलोड करा" निवडा.
- भाषा निवडा — डीफॉल्टनुसार इंग्रजी; रशियन मजकुरासाठी, स्वतःहून भाषा बदला.
- "तपासा" वर क्लिक करा आणि अहवाल तपासा: कोणती चिन्हे कोठे आढळली.
- क्लिअर बटणावर क्लिक करा आणि मजकुराची स्वच्छ केलेली प्रत कॉपी करा.
हे पान असे दिसते: एक टेक्स्ट फील्ड, URL द्वारे लोडिंग, भाषा निवड आणि हे साधन काय तपासते याची यादी.
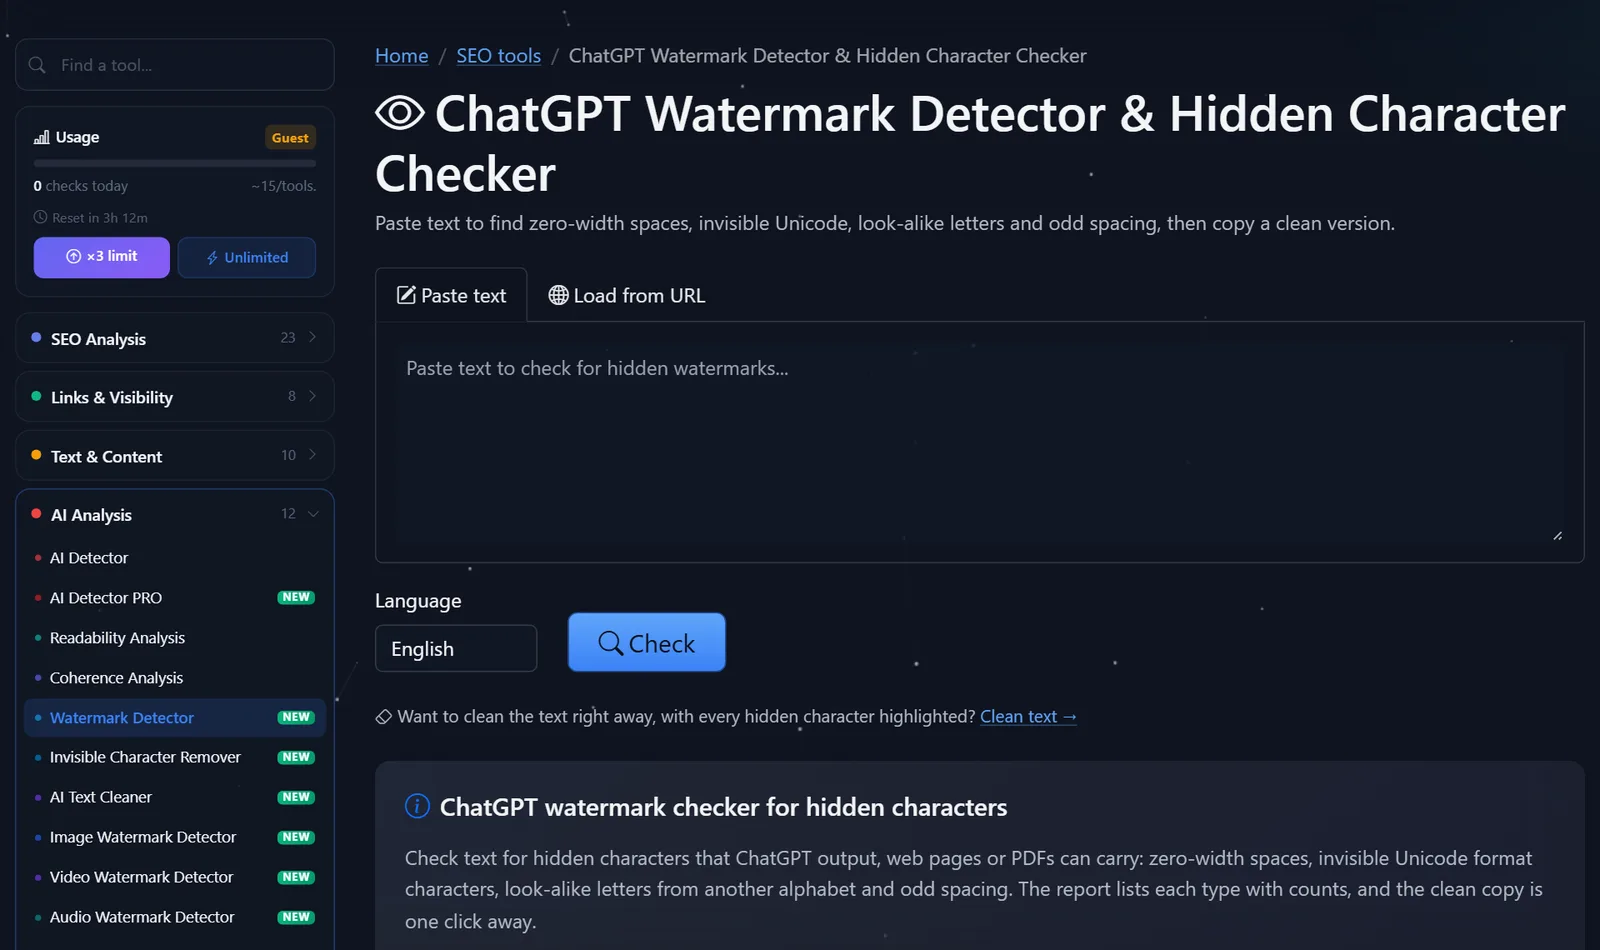
पाहुण्यांना दररोज अंदाजे १५ तपासण्या करण्याची सुविधा मिळते; मोफत नोंदणीनंतर, ते याच्या तिप्पट अधिक तपासण्या करू शकतात.
मजकुरात छुपी चिन्हे कुठून येतात आणि त्यांचा उपयोग काय करायचा असतो?
बहुतेक वेळा, अदृश्य वस्तू वाईट हेतूने नव्हे, तर नक्कल केल्यामुळे दिसतात:
- एआय चॅट्स आणि मेसेंजर्समधून, प्रतिसादाच्या फॉरमॅटिंगसोबत सर्व्हिस स्पेसेस आणि चिन्हे पुढे नेली जातात.
- PDF आणि Word मधून - हायफन, सॉफ्ट हायफन, नॉन-ब्रेकिंग स्पेसेस आणि BOM.
- इतर साइट्सवरून - कधीकधी मुद्दामहून: अशा प्रकारे ते मजकुराची नक्कल होण्यापासून संरक्षण करतात आणि तो कोठे दिसतो याचा मागोवा ठेवतात.
- कॉपीरायटर किंवा कंत्राटदाराच्या मते - युनिकनेस तपासणीत 'चूक' करण्यासाठी कधीकधी होमोग्लिफ्सचा वापर केला जातो.
अहवालाचे काय करावे:
- टायटल्स, युआरएल आणि मेटा टॅग्जमधून झिरो-विड्थ कॅरेक्टर्स आणि बीओएम नेहमी काढून टाका. कोणत्याही परिस्थितीत त्यांना तिथे स्थान नाही.
- मुख्य मजकुरातील समोच्चारित अक्षरे काढून टाकली पाहिजेत आणि त्यांच्या उगमाची चौकशी केली पाहिजे. जर मजकूर एखाद्या कॉपीरायटरने सादर केला असेल, तर समोच्चारित अक्षरे ही चिंतेची बाब असली पाहिजे: हे वेगळेपणाचा आभास निर्माण करण्याचे एक पारंपरिक तंत्र आहे.
- संख्या आणि एकक यांच्यामध्ये न तुटणाऱ्या जागा ("5 €," "10 min") ठेवल्या जाऊ शकतात. ही एक सामान्य टायपोग्राफी आहे, आणि हे साधन अनुभवावर आधारित असल्याने त्यांना संशयास्पद म्हणून चिन्हांकित करू शकते.
- दुसऱ्याच्या मजकुरात स्टेगनोग्राफिक (गुप्त संकेत) घालणे हे या गोष्टीचे लक्षण आहे की मूळ लेखक प्रतींवर लक्ष ठेवून आहे. मजकूर संपादित न करता, स्वतःचा मजकूर लिहिणे अधिक चांगले आहे: टॅग्ज ही मुख्य समस्या नाही; मुख्य समस्या कॉपीराइटची आहे.
छुपे वर्ण एसईओवर कसा परिणाम करतात?
अदृश्य अक्षर ही 'डिझाइनमधील त्रुटी' नसून, एक खरी तांत्रिक समस्या आहे. याचा सर्वाधिक फटका येथे बसतो:
- शीर्षक आणि H1. U+200B असलेला "delivery" हा शब्द शोध इंजिनला "dost" आणि "avka" या दोन तुकड्यांच्या रूपात दिसतो. पृष्ठ क्वेरीशी कमी जुळते आणि स्निपेटमध्ये कधीकधी एक विचित्र पोकळी दिसते.
- URL आणि स्लग. जर अदृश्य टॅग असलेले शीर्षक आपोआप पेजच्या पत्त्यामध्ये रूपांतरित होत असेल, तर URL मध्ये
%E2%80%8Bसारखा एन्कोड केलेला निरर्थक मजकूर असेल. ही लिंक कॉपी करणे कठीण असते आणि संशयास्पद दिसते. - संरचित डेटा आणि फीड्स. उत्पादनाच्या नावातील BOM सिम्बॉल किंवा होमोग्लिफमुळे मार्केटप्लेस किंवा मर्चंट सेंटर फीडमध्ये अडथळा येऊ शकतो आणि उत्पादन मॉडरेशनमध्ये पास होणार नाही.
- वेबसाइटवरील शोध आणि फिल्टर्स. एक ग्राहक "केबल" शोधतो, परंतु उत्पादन सूचीमध्ये "e" सह "केबल" असे लिहिलेले असते—वस्तू अस्तित्वात असूनही सापडत नाही.
- एआय सहाय्यकाचे प्रतिसाद. मॉडेल बदललेली अक्षरे असलेले शब्द चुकीच्या पद्धतीने ओळखू शकतात, म्हणजेच तुमचा मजकूर वापरकर्त्याच्या प्रश्नाशी जुळण्याची शक्यता कमी असेल.
म्हणूनच, विशेषतः मोठ्या प्रमाणात आयात करताना, शीर्षके, पत्ते आणि उत्पादन कार्डांमध्ये येणाऱ्या प्रत्येक गोष्टीत अदृश्य गोष्टी नाहीत ना, हे मी तपासतो.
हे टूल ChatGPT आणि SynthID वॉटरमार्क शोधेल का?
मजकुरातील दोन प्रकारच्या वॉटरमार्क्समधील फरक ओळखणे महत्त्वाचे आहे.
सांकेतिक वर्ण मजकुरात चिन्हांच्या स्वरूपात आढळतात: अदृश्य वर्ण, होमोग्लिफ्स आणि फॉरमॅटिंग. प्रोमोपायलट डिटेक्टर त्यांना शोधून काढून टाकतो.
सांख्यिकीय घटक हे मॉडेल तयार करताना वापरल्या जाणाऱ्या शब्द निवडीमध्येच अंतर्भूत असतात. उदाहरणार्थ, Google आपल्या मॉडेल्सच्या मजकुरात एक SynthID वॉटरमार्क समाविष्ट करते आणि SynthID Detector नावाच्या एका वेगळ्या पोर्टलमध्ये त्याची तपासणी करते. हा वॉटरमार्क 'क्लिअर' बटणाने काढता येत नाही: ते एक चिन्ह नसून, शब्दरचनेतील एक नमुना आहे. हे साधन किंवा इतर कोणतेही चिन्ह तपासणारे ते शोधू शकणार नाहीत.
त्यामुळे, "स्वच्छ" केलेला मजकूर "एआय डिटेक्टरसाठी अदृश्य" होत नाही—आणि तसे व्हायलाही नको. मजकूर स्वच्छ करण्याचा उद्देश हा आहे की तो वेबसाइटवर योग्यरित्या कार्य करेल: तो शोधण्यायोग्य, कॉपी करण्यायोग्य आणि योग्यरित्या प्रदर्शित होईल.
तुलना: प्रोमोपायलट वॉटरमार्क डिटेक्टर आणि पर्याय
| साधन | काय मोफत आहे? | निर्बंध | हे कोणासाठी योग्य आहे? |
|---|---|---|---|
| प्रोमोपायलट — मजकूर वॉटरमार्क शोधक | ५ टॅग प्रकारांसाठी शोध, अहवाल, एका क्लिकमध्ये स्वच्छता, URL तपासणी | केवळ मूळ मजकूर, DOC/PDF नाही; दररोजच्या अतिथींची मर्यादा | लेखक, संपादक आणि वेबसाइट मालकांसाठी |
| कोड एडिटर (उदा. व्हीएस कोड) | अदृश्य आणि समान चिन्हे ठळक करणे | तुम्हाला प्रोग्राम इन्स्टॉल करून तो स्वतःहून स्वच्छ करावा लागेल. | विकसकांसाठी |
| नियमित अभिव्यक्ती शोध | संपादकामध्ये [-] शोधा | या पद्धतीने होमोग्लिफ्स शोधता येत नाहीत; त्यासाठी कौशल्याची गरज असते. | जे लोक मोठ्या प्रमाणात मजकुरासोबत काम करतात त्यांच्यासाठी |
| Google सिंथआयडी डिटेक्टर | सिंथआयडी वॉटरमार्क पडताळणी | केवळ Google एआय सामग्री; प्रवेश मर्यादित | पत्रकार आणि संशोधकांसाठी |
निष्कर्ष: प्रकाशनापूर्वी दैनंदिन मजकूर तपासणीसाठी, ऑनलाइन डिटेक्टर सर्वात सोयीस्कर आहे – ते चिन्हे आणि होमोग्लिफ्स दोन्ही शोधते आणि त्वरित एक स्वच्छ प्रत तयार करते.
प्रोमोपायलटच्या कॅटलॉगमध्ये ८७ मोफत एसईओ टूल्स आहेत, ज्यात प्रतिमा, व्हिडिओ आणि ऑडिओसाठी खास वॉटरमार्क डिटेक्टरचा समावेश आहे; या ब्लॉग विभागातील एका स्वतंत्र लेखात त्या प्रत्येकाची माहिती दिली आहे.
मजकुरावर वॉटरमार्क तपासण्याच्या मर्यादा कोणत्या?
- केवळ साधा मजकूर. बायनरी DOC आणि PDF फाईल्स समर्थित नाहीत—त्यांमधून मजकूर कॉपी आणि पेस्ट करा.
- अनुमान: एखादे संशयास्पद अक्षर नेहमीच हानिकारक नसते: नॉन-ब्रेकिंग स्पेस किंवा सॉफ्ट हायफन योग्य असू शकतात.
- सांख्यिकीय वॉटरमार्क दिसत नाहीत. हे साधन शब्दांमधील नमुने नव्हे, तर चिन्हे शोधते.
- मजकूर स्वच्छ केल्याने तो अद्वितीय बनत नाही. जर मजकूर दुसऱ्या कोणाचा असेल, तर तो स्वच्छ केल्यानंतरही दुसऱ्या कोणाचाच राहतो.
एखादे मोफत साधन केव्हा पुरेसे नसते?
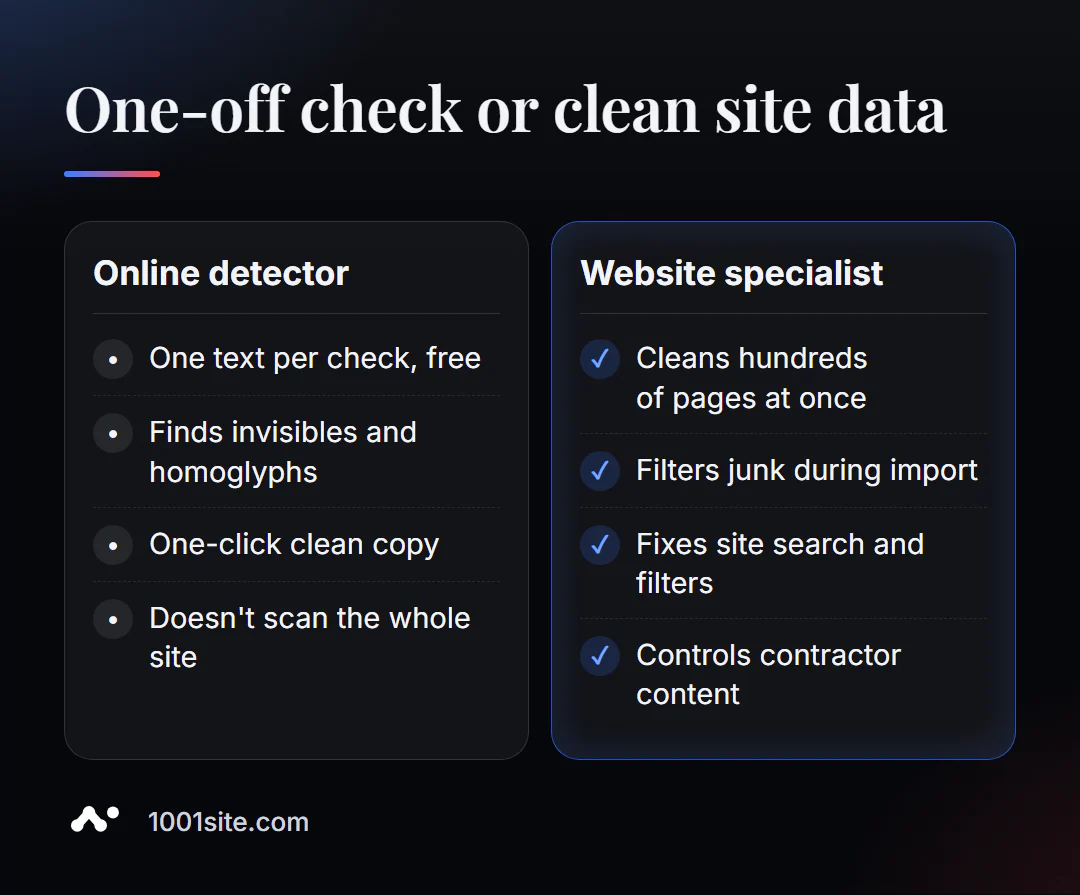
एकदाच केलेले पुनरावलोकन एकाच मजकुराची समस्या सोडवते. खालील परिस्थितीत तज्ञाची आवश्यकता असते:
- शेकडो उत्पादन कार्ड आणि लेखांमध्ये आधीच छुपी चिन्हे वितरित करण्यात आली आहेत;
- साइटवर कंत्राटदार, एआय आणि सोशल नेटवर्क्सवरून आयात केलेल्या सामग्रीचा ओघ सुरू असतो;
- साइटवरील शोध आणि फिल्टर्स विचित्रपणे वागत आहेत आणि त्याचे कारण अस्पष्ट आहे;
- आम्हाला आयातीच्या वेळी स्वयंचलित मजकूर साफसफाईची गरज आहे, मॅन्युअलची नाही.
मी तुमच्या वेबसाइटसाठी काय करू शकेन?
मी वलेरी डॅन्युक, १२ वर्षांचा अनुभव आणि २०० हून अधिक ग्राहकांसह एक डेव्हलपर आणि एसईओ तज्ञ आहे. मी तयार करत असलेल्या प्रत्येक बिल्डमध्ये डेटाची अखंडता हा एक महत्त्वाचा भाग असतो: इम्पोर्ट्स, कॅटलॉग्स आणि ऑटोमेशन.
एसईओ आणि सामग्री
- टर्नकी वेबसाइट एसईओ ऑडिट: मी केवळ एकाच पानावर नव्हे, तर संपूर्ण साइटवर सदोष शीर्षके, पुनरावृत्ती आणि सदोष डेटा शोधतो.
- नैसर्गिक ग्राहकांना आकर्षित करणारा एसईओ ब्लॉग – एआय-शक्तीवर आधारित मजकूर प्रकाशित करण्यापूर्वी त्याचे पुनरावलोकन केले जाते.
वेबसाइट्स आणि डिरेक्टरीज
- MCP आणि Claude द्वारे अवघ्या काही मिनिटांत ३०० उत्पादनांची कॅटलॉग — डेटाचा अपव्यय न करता मोठ्या प्रमाणात आयात.
- Instagram वेबसाइटवर स्टोअर स्थानांतरित करताना, सोशल मीडियावरील मजकूर देखील सुव्यवस्थित करणे आवश्यक असते.
- €299 मध्ये एआय असिस्टंट असलेली WordPress वेबसाइट किंवा लिंकद्वारे कंटेंट ट्रान्सफरची सुविधा असलेली 1001site वेबसाइट.
ऑटोमेशन
- किंमतींची आपोआप गणना करणारे आणि पावत्या छापणारे CRM हे एक असे उदाहरण आहे, जिथे अचूक डेटाला सर्वाधिक महत्त्व असते.
- क्वेस्टफ्लो हा एआय (AI) असलेला एक Telegram बॉट बिल्डर आहे.
जर साईटला एखादी गोष्ट सापडत नसेल जी नक्कीच तिथे आहे, तर मला Telegram लिहा, आणि आपण त्याचे कारण शोधू.
निकाल
- छुपी चिन्हे आणि समोच्चारित अक्षरे डोळ्यांना दिसत नाहीत, परंतु ती शोध, शीर्षके आणि कीवर्डमध्ये अडथळा आणतात.
- वॉटरमार्क डिटेक्टर ५ प्रकारचे चिन्ह शोधतो आणि एका क्लिकमध्ये स्वच्छ केलेला मजकूर मोफत उपलब्ध करून देतो.
- सांख्यिकीय एआय वॉटरमार्क (जसे की SynthID) चिन्हांमध्ये अंतर्भूत केलेले नसतात; त्यांची तपासणी इतर साधनांद्वारे केली जाते.
- जर "कचरा" आधीच संपूर्ण साइटवर पसरला असेल, तर संपूर्ण डेटा साफसफाई आवश्यक आहे - किंवा 1001site वर काळजीपूर्वक आयात करून नवीन साइट तयार करावी लागेल.
तुमची पुढची पोस्ट करण्यापूर्वी , तुमच्या मजकुरात छुपे वर्ण आहेत का ते तपासा, विशेषतः जर तो मजकूर चॅट किंवा पीडीएफमधून घेतलेला असेल.
स्रोत
- प्रोमोपायलटच्या वॉटरमार्क डिटेक्टर टूलचे पान — वॉटरमार्कचे प्रकार, मर्यादा, उदाहरण.
- Google - सिंथआयडी डिटेक्टर पोर्टलची घोषणा.
- युनिकोड मानक - शून्य-रुंदीचे वर्ण आणि विशेष वर्णांसाठीचे संकेत.